Cette page s’affiche en anglais en attendant une traduction complète.
Retour à l’AcadémieHistoire de l'Intelligence Artificielle
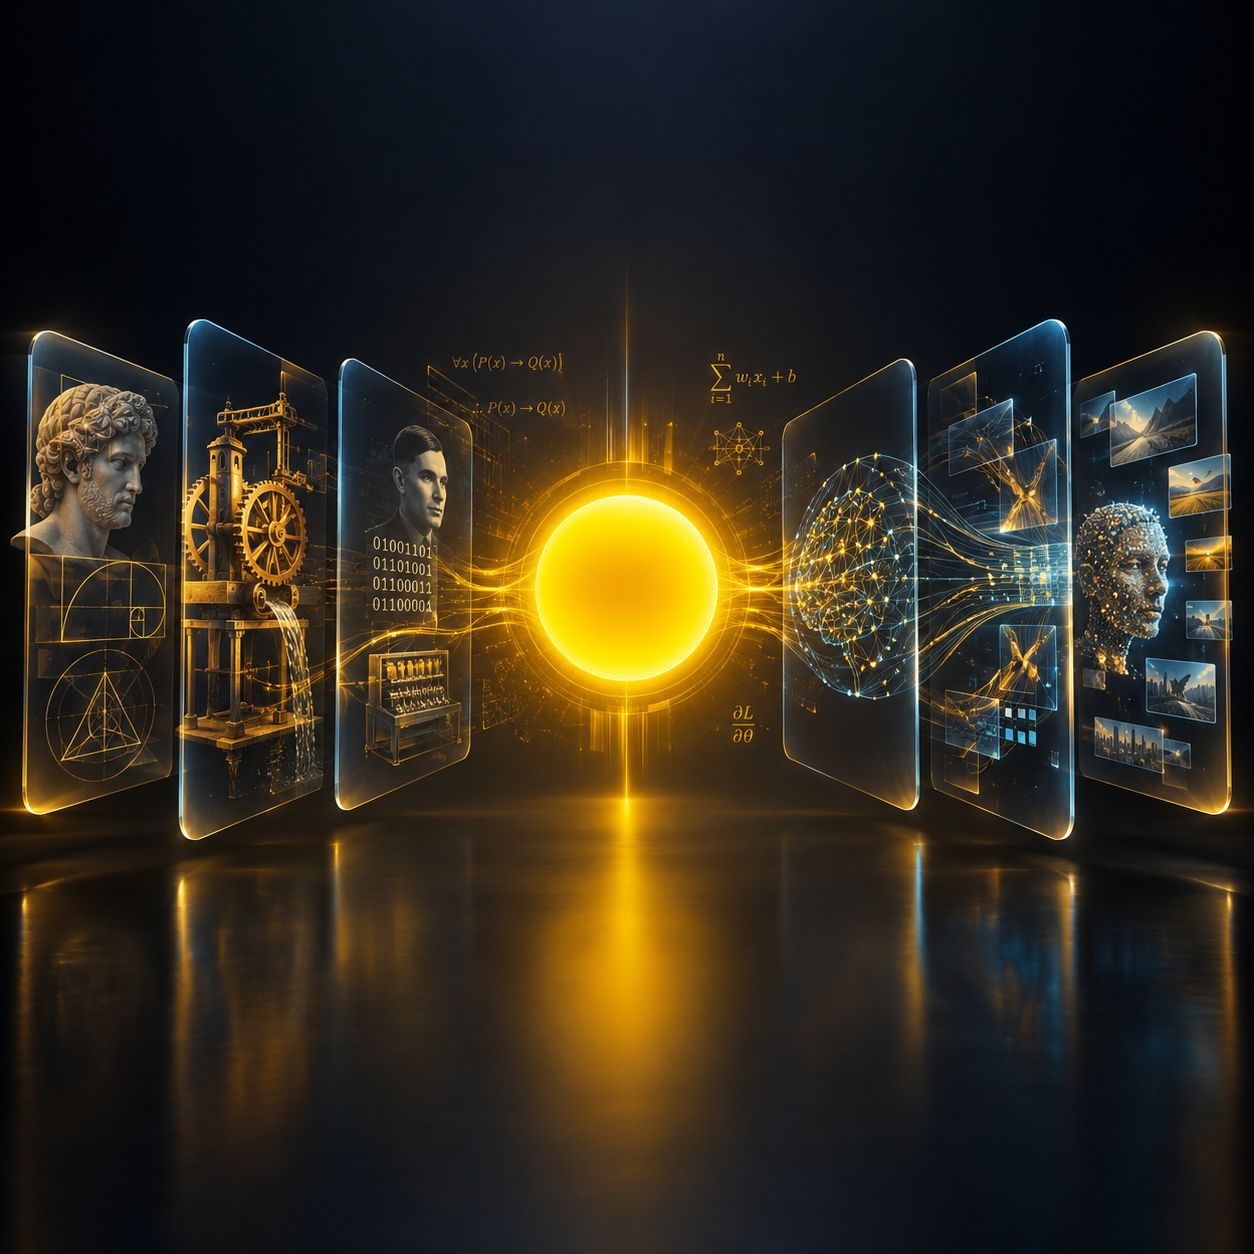
L'idée de créer une machine capable de penser et de prendre des décisions à l'instar de l'être humain ne date pas de l'avènement des ordinateurs modernes ; ses racines plongent dans plusieurs millénaires d'histoire. Tout au long de l'histoire de l'humanité, de nombreux philosophes, penseurs et scientifiques ont tenté d'interroger les fondements mêmes de la connaissance : « Quelle est la nature de l'intelligence ? » et « L'intelligence peut-elle être reproduite artificiellement ? ». Ces interrogations théoriques ont constitué le socle intellectuel qui a finalement conduit à l'émergence de l'intelligence artificielle (IA) en tant que discipline scientifique autonome.
Dans la Grèce antique, des philosophes tels que Platon (Plato) et Aristote (Aristotle) ont accordé une importance capitale à la logique, à la pensée structurée et aux méthodes d'accès au savoir. Aristote a notamment élaboré le premier système formalisé de logique, en établissant les règles du raisonnement déductif (le syllogisme). Bien que ces travaux pionniers n'aient pas mené directement à la création d'une intelligence artificielle, ils ont posé le principe fondamental selon lequel la pensée humaine peut être décrite de manière symbolique à travers des règles et des principes définis.
Au Moyen Âge et au début de l'époque moderne, mathématiciens et philosophes ont cherché à développer de manière systématique l'intégration de la logique et des mathématiques. Au XVIIe siècle, Gottfried Wilhelm Leibniz a proposé un langage symbolique universel pour exprimer la logique et les concepts (Characteristica universalis). Il soutenait que si toutes les pensées pouvaient être traduites en lois mathématiques, les futures machines à calculer seraient capables de résoudre des problèmes complexes par le calcul. Bien que cette idée fût irréalisable à son époque, elle a constitué un fondement rationaliste majeur pour l'intelligence artificielle.
Au XIXe siècle, des progrès techniques déterminants ont été accomplis dans le domaine du calcul et de l'automatique. Charles Babbage a conçu la « Machine analytique » (Analytical Engine), qui intégrait déjà plusieurs caractéristiques essentielles des ordinateurs modernes : une mémoire (Memory), une unité de calcul (ALU) et la capacité d'être programmée. Bien que cette machine n'ait jamais été entièrement construite, les historiens des sciences la considèrent comme la première conception d'un ordinateur universel.
À la même époque, Ada Lovelace — considérée comme la première programmatrice de l'histoire — a émis une observation particulièrement visionnaire. Elle a prédit que les futures machines à calculer ne se limiteraient pas au traitement des nombres, mais seraient également capables de manipuler de la musique, des images et divers formats de données non structurées. Cette intuition était extrêmement novatrice pour son temps et a joué plus tard un rôle crucial dans l'élargissement des horizons de l'intelligence artificielle.
Au début du XXe siècle, le développement de la logique formalisée et des fondements mathématiques s'est considérablement accéléré. Les travaux de George Boole sur l'algèbre booléenne, suivis des recherches de Gottlob Frege, Bertrand Russell et Alfred North Whitehead, ont offert une structure rigoureuse à la logique mathématique. Ces contributions ont démontré que certains schémas de la pensée humaine pouvaient être formulés par des règles formelles et exécutés par une machine automatique.
La rupture paradigmatique la plus majeure de cette étape est issue des travaux fondamentaux d'Alan Turing. En 1936, dans son article historique intitulé On Computable Numbers, with an Application to the Entscheidungsproblem, Turing a introduit le modèle théorique de la « Machine de Turing » (Turing Machine). Il a démontré mathématiquement que tout processus logique, dès lors qu'il peut être décrit avec précision par un algorithme, peut être exécuté par une machine de Turing universelle. Ce concept théorique est devenu le pilier fondamental de l'informatique et de l'intelligence artificielle.
Après la Seconde Guerre mondiale, l'avènement des ordinateurs électroniques a offert le cadre matériel nécessaire à la mise en œuvre pratique de ces théories. En 1950, Turing a publié dans la revue Mind son article fondateur intitulé Computing Machinery and Intelligence, posant la question historique : « Les machines peuvent-elles penser ? » (Can machines think?). Il a en outre proposé un test pratique pour évaluer le comportement intelligent d'un système informatique — méthode connue aujourd'hui sous le nom de « Test de Turing » (Turing Test).
L'ensemble de ces avancées — de la logique grecque antique à la philosophie mathématique de Leibniz, de la machine analytique de Babbage à la vision computationnelle de Lovelace et aux théories de la calculabilité de Turing — a constitué le socle scientifique et intellectuel nécessaire à la naissance de l'intelligence artificielle. Ce parcours a culminé en 1956 lors de la Conférence de Dartmouth (Dartmouth Conference), marquant la naissance officielle de l'intelligence artificielle comme champ d'étude scientifique autonome.
Al-Jazari et l'ingénierie précoce des automates (Al-Jazari and Automata)
Des siècles avant la naissance officielle de l'intelligence artificielle, les tentatives de création de dispositifs automatiques et de systèmes autonomes ont posé des bases pratiques et d'ingénierie essentielles pour le développement ultérieur de la robotique et du génie mécanique. L'un des pionniers les plus éminents dans ce domaine fut Badi al-Zaman Abu al-'Izz ibn Ismail ibn al-Razzaz al-Jazari (Ismail al-Jazari, 1136–1206 apr. J.-C.). Al-Jazari a vécu à Amed (l'actuelle Diyarbakır), dans le nord du Kurdistan, et a servi pendant près de cinquante ans en tant qu'ingénieur en chef à la cour de la dynastie des Artukides.
En 1206, al-Jazari a achevé son chef-d'œuvre d'ingénierie, le Livre de la connaissance des procédés mécaniques ingénieux (The Book of Knowledge of Ingenious Mechanical Devices). Cet ouvrage est considéré comme l'un des documents historiques les plus importants du génie mécanique ; il y décrit en détail environ 50 automates et mécanismes complexes, accompagnés de schémas précis et d'explications techniques. Ses inventions comprenaient des horloges hydrauliques sophistiquées, des pompes hydrauliques à double effet (Double-acting Pump), des serviteurs automatiques, des mécanismes de lavage automatique des mains et des ensembles musicaux mécaniques — fonctionnant tous de manière autonome sans intervention humaine grâce à la mécanique des fluides, à la gravité et à des systèmes de cames (Cam Mechanism).
De nombreux historiens des technologies considèrent al-Jazari comme l'un des pères du génie mécanique et de la théorie du contrôle automatique. Bien que les machines d'al-Jazari ne possèdent pas d'intelligence artificielle au sens moderne du terme — c'est-à-dire sans capacité d'apprentissage, de prise de décision ou d'adaptation autonome —, ses travaux d'ingénierie constituent une étape historique majeure vers la conception d'automates humanoïdes et de systèmes autonomes.
Alan Turing et le Test de Turing (Alan Turing and the Turing Test)
Alan Mathison Turing (1912–1954) est reconnu comme l'un des fondateurs essentiels de l'informatique et de l'intelligence artificielle. Ses recherches ont non seulement fourni un cadre théorique à la science du calcul, mais ont également inauguré un nouveau paradigme pour évaluer la capacité des machines à imiter l'intelligence humaine. De surcroît, Turing a joué un rôle déterminant durant la Seconde Guerre mondiale dans le décryptage de la machine allemande « Enigma », influençant considérablement la victoire des Alliés et le développement des ordinateurs modernes.
Le modèle de la Machine de Turing et les fondements de la calculabilité
En 1936, Turing a publié son article historique On Computable Numbers, with an Application to the Entscheidungsproblem, dans lequel il présente le modèle mathématique abstrait de la « Machine de Turing ».
Il ne s'agissait pas d'un dispositif physique, mais d'une construction mathématique démontrant comment tout processus logique peut être décomposé en instructions séquentielles gérées étape par étape. La portée majeure de ce modèle résidait dans la démonstration de la calculabilité algorithmique : tout problème pouvant être exprimé sous forme d'algorithme est théoriquement solvable par une machine de Turing universelle. Cette idée constitue la pierre angulaire de toute l'informatique moderne.
« Les machines peuvent-elles penser ? »
En 1950, Turing a publié dans la revue philosophique Mind son article célèbre Computing Machinery and Intelligence, qui s'ouvre sur la question incisive :
« Can machines think? » (« Les machines peuvent-elles penser ? »)
Turing soutenait que le terme « penser » était trop ambigu sur le plan philosophique et sémantique. Il a donc proposé de substituer à cette question abstraite un test comportemental pratique permettant d'évaluer les performances opérationnelles des systèmes informatiques.
Le Test de Turing (The Turing Test)
Conçu à l'origine sous le nom de « Jeu de l'imitation » (Imitation Game), ce test implique trois participants principaux :
Un participant humain (servant de référence) ;
Un ordinateur ou système d'IA (cherchant à imiter le comportement humain) ;
Un évaluateur humain (juge) situé dans une pièce séparée, statuant dans des conditions d'aveugle.
L'évaluateur communique avec les deux parties exclusivement par échange de messages textuels. Si, au terme du protocole, l'évaluateur ne peut distinguer de façon fiable la machine de l'être humain, la machine est considérée comme ayant réussi le test.
Note académique : L'objectif de ce test n'est pas de prouver que la machine possède une « conscience » ou des « sentiments », mais uniquement de mesurer si son comportement linguistique et conversationnel atteint un niveau équivalent à celui d'un humain.
Impact sur le développement de l'Intelligence Artificielle
Le Test de Turing est devenu l'un des étalons les plus influents de l'histoire de l'intelligence artificielle. Il a fourni pour la première fois un cadre opérationnel pour évaluer les capacités des systèmes intelligents. Cette perspective a profondément orienté la recherche après 1950, stimulant le développement des agents conversationnels (Chatbots), des systèmes de question-réponse et des grands modèles de langage modernes (LLMs).
Au XXIe siècle, l'avènement des modèles de langage avancés a relancé les débats autour du Test de Turing. Bien que certains systèmes modernes fassent preuve de capacités conversationnelles impressionnantes, la communauté scientifique s'accorde sur le fait que la seule réussite au Test de Turing ne constitue pas une preuve d'Intelligence Artificielle Générale (AGI) ni de conscience, car un système peut générer un comportement de type humain par appariement statistique de motifs sans détenir de compréhension réelle.
Critiques et limites théoriques
Malgré sa portée historique, le Test de Turing a fait l'objet de critiques formulées par des chercheurs et philosophes. Notamment, John Searle, à travers son expérience de pensée de la « Chambre chinoise » (Chinese Room), a démontré qu'un système peut manipuler des symboles en suivant des règles syntaxiques (Syntax) sans posséder la moindre compréhension du sens (Semantics). De plus, les sciences cognitives soulignent que l'intelligence humaine ne se limite pas à l'interaction verbale, mais est profondément ancrée dans la perception de l'environnement, la prise de décision et l'interaction avec le monde réel.
La Conférence de Dartmouth et la naissance officielle de l'IA (The Dartmouth Conference and the Formal Birth of AI)
La majorité des historiens de l'informatique et la communauté académique considèrent l'année 1956 comme la date de naissance officielle de l'Intelligence Artificielle (Artificial Intelligence, AI) en tant que discipline scientifique autonome. Durant l'été de cette année-là, un séminaire de recherche historique s'est tenu au Dartmouth College, situé dans l'État du New Hampshire (États-Unis), événement connu plus tard sous le nom de « Dartmouth Summer Research Project on Artificial Intelligence ».
Cette conférence constituait la première tentative systématique d'établir un champ d'étude indépendant, entièrement dédié à l'analyse des méthodes permettant de concevoir des systèmes capables de manifester un comportement intelligent.
Origines du projet et pionniers (Origins and Pioneers)
L'idée de cette conférence a été initialement proposée par John McCarthy, considéré plus tard comme le « père de l'intelligence artificielle ». À ses côtés, d'autres pionniers ont participé à la rédaction de la proposition : Marvin Minsky, Nathaniel Rochester d'IBM et Claude Shannon, le fondateur de la théorie de l'information (Information Theory).
Le texte de la proposition scientifique énonçait l'hypothèse académique fondamentale suivante :
« Chaque aspect de l'apprentissage ou toute autre caractéristique de l'intelligence peut en principe être décrit avec une telle précision qu'une machine peut être construite pour le simuler exactement. »
Cette formulation est devenue un socle intellectuel majeur pour les chercheurs de l'époque ; ils étaient pleinement convaincus que l'intelligence humaine pouvait être formalisée par des règles, des algorithmes et de la puissance de calcul, puis exécutée par un ordinateur.
La naissance du terme « Artificial Intelligence » (Birth of the Term "Artificial Intelligence")
L'un des résultats les plus significatifs et historiques de la conférence de Dartmouth a été l'introduction officielle, par John McCarthy, du terme « Artificial Intelligence » (Intelligence Artificielle) au niveau académique. Avant cette date, les recherches dans ce domaine s'effectuaient sous diverses appellations telles que la Cybernétique (Cybernetics), la théorie des automates (Automata Theory) ou le traitement de l'information complexe (Complex Information Processing).
Le choix de cette nouvelle dénomination répondait à un objectif stratégique : McCarthy souhaitait distinguer ce champ d'étude des autres disciplines scientifiques et lui conférer une identité académique propre. En ce sens, l'année 1956 ne marque pas seulement la tenue d'une conférence, mais la fondation institutionnelle d'une nouvelle discipline scientifique.
Objectifs principaux de la conférence (Primary Objectives of the Conference)
Les chercheurs réunis à Dartmouth prévoyaient avec un grand optimisme qu'ils parviendraient à résoudre les problèmes majeurs de l'intelligence humaine en l'espace de quelques années. Leurs objectifs fondamentaux incluaient :
La conception de systèmes d'apprentissage automatique (Machine Learning) ;
La compréhension et le traitement du langage naturel (Natural Language Processing, NLP) ;
La formalisation des mécanismes de résolution de problèmes et de prise de décision ;
L'analyse formelle de la pensée logique et abstraite ;
Le développement de capacités de reconnaissance d'images et d'objets ;
La construction d'une machine capable d'exhiber un comportement rigoureusement équivalent à celui de l'être humain.
Bien que les chercheurs aient cru à l'époque que ces objectifs seraient atteints dans un avenir proche, les développements ultérieurs ont prouvé que l'intelligence humaine est d'une complexité et d'une profondeur bien supérieures aux modèles théoriques initiaux.
Impact académique et soutien institutionnel (Academic Impact and Institutional Support)
Bien que la conférence de Dartmouth n'ait pas produit immédiatement de percée ingénierique majeure, son impact sur l'orientation de la science informatique a été monumental. À la suite de cet événement, les plus grandes universités mondiales ont commencé à créer des laboratoires dédiés à l'IA, notamment le Massachusetts Institute of Technology (MIT), l'Université de Stanford et l'Université Carnegie Mellon.
Parallèlement, le gouvernement américain et des agences fédérales telles que la DARPA ont alloué des financements considérables pour soutenir les recherches dans ce domaine émergent. Ce soutien financier est devenu le moteur essentiel du développement des premiers programmes intelligents et des progrès de l'apprentissage automatique.
Les premières percées pionnières : années 1950–1960 (Early Breakthroughs: 1950s–1960s)
Dans la seconde moitié des années 1950 et au début des années 1960, plusieurs projets fondateurs ont vu le jour, parmi lesquels :
Logic Theorist (1956) : Développé par Allen Newell et Herbert A. Simon ; considéré comme le premier programme d'IA de l'histoire, capable de démontrer des théorèmes de logique symbolique.
General Problem Solver (GPS) : Une tentative pionnière visant à concevoir un système universel de résolution de problèmes logiques.
Le langage de programmation LISP (1958) : Inventé par John McCarthy lui-même ; il est demeuré pendant plusieurs décennies le langage fondamental de la recherche mondiale en IA.
Ces réussites, malgré leurs limites, ont démontré que les ordinateurs pouvaient exécuter avec succès des tâches de raisonnement logique.
Les Hivers de l'IA (AI Winters)
Après l'essor prometteur de l'intelligence artificielle à la fin des années 1950 et au début des années 1960, de nombreux chercheurs et organismes de financement estimaient avec optimisme que les ordinateurs pourraient assumer la majorité des tâches intellectuelles humaines en quelques années. Cependant, ces attentes élevées ne correspondaient pas aux capacités réelles du matériel et de l'ingénierie de l'époque.
L'écart béant entre les promesses et la réalité a entraîné des effondrements périodiques des financements, de la confiance du public et des activités de recherche. Dans l'histoire des technologies, ces phases de stagnation sont connues sous le nom d'« Hivers de l'IA » (AI Winters).
L'expression « Hiver de l'IA » désigne des cycles historiques au cours desquels les soutiens financiers et les espoirs du public ont chuté drastiquement, en raison de l'incapacité des résultats pratiques à atteindre le niveau des prédictions ambitieuses formulées par les chercheurs et les entreprises. Ces hivers ont constitué des tournants cruciaux dans l'histoire de l'IA, contraignant la discipline à réévaluer ses approches théoriques et ses méthodologies.
Le premier hiver de l'IA : les années 1970 (The First AI Winter: 1970s)
Le premier hiver de la discipline a débuté à la fin des années 1960 et au début des années 1970. À cette époque, bien que les premiers programmes intelligents tels que Logic Theorist, GPS et ELIZA aient suscité l'attention des médias et du monde scientifique, leurs capacités demeuraient extrêmement limitées. La plupart de ces systèmes ne fonctionnaient que dans des environnements de laboratoire hautement simplifiés et échouaient face à la complexité du monde réel.
Le livre Perceptrons (1969) : Cette année-là, Marvin Minsky et Seymour Papert ont publié leur célèbre ouvrage Perceptrons, dans lequel ils démontraient les limites mathématiques des réseaux de neurones artificiels monocouches. Bien que leur critique fût scientifiquement fondée, de nombreux financeurs l'ont interprétée comme la preuve que les réseaux de neurones n'avaient aucun avenir, entraînant le gel des recherches dans ce domaine pendant près de deux décennies.
Le rapport Lighthill (1973) : En 1973, le gouvernement britannique a publié un rapport d'évaluation stratégique intitulé Lighthill Report. Rédigé par le mathématicien Sir James Lighthill, ce document critiquait sévèrement les limites de l'IA et l'absence de résultats pratiques probants. À la suite de sa publication, les financements de la majorité des projets d'IA au Royaume-Uni ont été coupés, provoquant une onde de choc négative à l'échelle internationale.
Le renouveau des espoirs : les années 1980 (The Revival of Hope: 1980s)
Dans les années 1980, l'intelligence artificielle a de nouveau capté l'intérêt des entreprises et des gouvernements, principalement grâce au succès commercial des systèmes experts (Expert Systems). Ces systèmes modélisaient les connaissances et l'expertise de spécialistes dans un domaine précis pour les appliquer à la prise de décision et à la résolution de problèmes. Des géants industriels tels que Digital Equipment Corporation (DEC) et IBM ont investi des sommes considérables dans cette voie.
À la même époque, le gouvernement japonais a lancé son grand projet national baptisé « Systèmes informatiques de cinquième génération » (Fifth Generation Computer Systems, FGCS), visant à construire des ordinateurs hautement intelligents capables de résoudre des problèmes extrêmement complexes. Ces initiatives ont suscité une nouvelle vague d'optimisme quant à l'avenir de l'intelligence artificielle.
Le second hiver de l'IA : fin des années 1980 et début des années 1990 (The Second AI Winter: Late 1980s–Early 1990s)
Malgré l'optimisme initial des années 1980, l'intelligence artificielle a une nouvelle fois heurté un obstacle technique et ingénierique majeur vers la fin de la décennie. Il est apparu que les systèmes experts (Expert Systems) entraînaient des coûts de conception et de maintenance extrêmement élevés, que la mise à jour de leurs bases de connaissances (Knowledge Base) était d'une grande complexité, et que leur capacité d'adaptation dans des environnements dynamiques et changeants demeurait très limitée.
Parallèlement à ces difficultés, le marché des ordinateurs personnels (PC) a connu une croissance exponentielle. De nombreuses entreprises et institutions se sont orientées vers des solutions matérielles et logicielles plus abordables et polyvalentes, ne nécessitant pas le recours à des équipements informatiques spécialisés et coûteux. En conséquence, de nombreuses sociétés du secteur de l'IA ont fait faillite, et les crédits de recherche se sont effondrés une nouvelle fois. Cette période est restée gravée dans l'histoire des technologies sous le nom de « second hiver de l'IA ».
Causes principales de la survenue des hivers de l'IA (Key Causes of AI Winters)
Une série de facteurs structurels et systémiques ont contribué au déclenchement de ces phases de stagnation :
Prédictions surévaluées et optimisme irréaliste : L'affirmation prématurée selon laquelle une Intelligence Artificielle Générale (AGI) équivalente à l'humain serait conçue à très court terme.
Limites physiques de la puissance de calcul : La faible vitesse de traitement et la capacité de mémoire restreinte des ordinateurs de l'époque face aux exigences des tâches cognitives complexes.
Absence de jeux de données adéquats : Le manque de données volumineuses et structurées de haute qualité nécessaires pour entraîner les modèles.
Limites théoriques des premiers algorithmes : L'absence d'algorithmes avancés capables d'extraire automatiquement des caractéristiques abstraites de haut niveau.
Fossé entre l'environnement de laboratoire et le monde réel : Le décalage profond entre les performances des systèmes dans des cadres expérimentaux contrôlés et leur instabilité face à la complexité du monde réel.
Désillusion des investisseurs : La coupe drastique des budgets de recherche par les gouvernements et le secteur privé suite au non-respect des promesses initiales.
L'essor de l'apprentissage automatique (The Rise of Machine Learning)
Après les crises successives des hivers de l'IA, les chercheurs ont pris conscience que l'approche classique dominante à ses débuts — reposant essentiellement sur des systèmes basés sur des règles (Rule-Based Systems) rédigés manuellement par des experts — présentait des limites théoriques franchissables uniquement par un changement de paradigme. Pour la majorité des phénomènes du monde réel, il était impossible de coder de manière exhaustive l'ensemble des règles et des hypothèses, les contextes et les flux de données étant en perpétuelle évolution.
C'est ainsi qu'a émergé un nouveau paradigme révolutionnaire dans la recherche : l'apprentissage automatique (Machine Learning, ML). Dans cette nouvelle approche, les ordinateurs n'attendent plus des instructions explicites et rigides, mais apprennent directement à partir des données pour identifier des motifs (patterns), dégager des structures et exécuter des tâches de manière autonome.
Progrès matériels et bond de la puissance de calcul (Hardware Advances)
Le développement de l'apprentissage automatique n'a pas dépendu uniquement de la découverte de nouveaux algorithmes ; les avancées technologiques matérielles ont joué un rôle de catalyseur déterminant. Au cours des années 1990 et au début des années 2000, les innovations architecturales apportées aux unités centrales de traitement (CPU) par des géants des semi-conducteurs tels qu'Intel et AMD ont augmenté de manière exponentielle la vitesse de calcul des ordinateurs. Cette avancée a permis de tester des modèles statistiques plus complexes et d'analyser des volumes de données considérablement plus importants.
Concept et définition de l'apprentissage automatique (Concept and Definition of Machine Learning)
L'apprentissage automatique est une branche fondamentale de l'intelligence artificielle dont l'objectif est de concevoir des logiciels et des algorithmes capables d'apprendre automatiquement à partir des données, de détecter des structures cachées et de formuler des prédictions ou des décisions précises, sans que le programmeur n'ait à expliciter manuellement chaque règle.
L'une des définitions les plus classiques et reconnues a été formulée en 1959 par le pionnier Arthur Samuel :
« L'apprentissage automatique est le champ d'étude qui donne aux ordinateurs la capacité d'apprendre sans être explicitement programmés. »
Facteurs clés de l'adoption de l'apprentissage automatique (Drivers of Machine Learning Adoption)
À la fin des années 1980 et tout au long des années 1990, plusieurs transformations majeures ont accéléré le déploiement de l'apprentissage automatique :
L'explosion de l'information numérique : La constitution des premiers grands jeux de données standardisés (Datasets).
L'augmentation des capacités matérielles : La hausse des vitesses de traitement et la baisse continue des coûts de stockage des données.
Les progrès dans les sciences fondamentales : L'intégration de la statistique mathématique, de la théorie des probabilités (Probability Theory) et des théories de l'optimisation au sein de la science informatique.
Les exigences du marché et de l'industrie : La forte demande commerciale des entreprises pour des systèmes de prédiction, de classification de données, ainsi que de reconnaissance d'images et de la voix.
Ces facteurs ont incité les chercheurs à abandonner la rédaction de milliers de lignes de règles rigides au profit de modèles statistiques flexibles, capables de chercher d'eux-mêmes la solution optimale au cœur des données.
Les trois grands paradigmes de l'apprentissage automatique (Major Paradigms of Machine Learning)
Les techniques d'apprentissage automatique se divisent principalement en trois grands paradigmes sur les plans théorique et ingénierique :
L'apprentissage supervisé (Supervised Learning) : Le modèle est entraîné sur un jeu de données contenant des étiquettes ou réponses cibles explicites (Labels). L'objectif principal est d'apprendre la fonction de correspondance entre les caractéristiques d'entrée et les étiquettes de sortie afin de réaliser des prédictions exactes sur de nouvelles données jamais observées.
Applications typiques : L'estimation des prix immobiliers, le filtrage des courriels indésirables (spam), et le diagnostic médical à partir d'imagerie.
L'apprentissage non supervisé (Unsupervised Learning) : Les données fournies au modèle ne comportent aucune étiquette ni réponse prédéfinie. L'algorithme cherche à découvrir par lui-même la structure sous-jacente, les regroupements naturels (Clusters) et les relations au sein des données.
Applications typiques : La segmentation de la clientèle selon le comportement (Customer Segmentation), la détection d'anomalies et de fraudes (Anomaly Detection), et la réduction de la dimensionnalité des données complexes.
L'apprentissage par renforcement (Reinforcement Learning) : Dans cette méthode, un agent (Agent) apprend par essais et erreurs (Trial and Error) au sein d'un environnement dynamique. Il reçoit une récompense (Reward) pour chaque action correcte et une pénalité (Penalty) en cas d'erreur. Au fil du temps, l'agent élabore une stratégie comportementale optimale visant à maximiser la récompense cumulée.
Applications typiques : La prise de décision dans des jeux complexes (Échecs, Go), le contrôle de systèmes robotiques, les véhicules autonomes et la gestion automatisée des réseaux.
Évolution algorithmique et résurgence des réseaux de neurones (Algorithmic Evolution and Resurgence of Neural Networks)
Au cours des années 1990 et 2000, plusieurs algorithmes statistiques avancés ont atteint leur maturité, posant les bases de l'apprentissage automatique moderne ; parmi eux figurent les arbres de décision (Decision Trees), les forêts aléatoires (Random Forests), les machines à vecteurs de support (Support Vector Machines, SVM), le classifieur naïf de Bayes (Naïve Bayes) et les k-plus proches voisins (k-Nearest Neighbors, k-NN). Ces méthodes ont obtenu de grands succès pratiques dans les domaines de l'économie, de la médecine et du traitement du langage naturel.
Parallèlement, bien que les réseaux de neurones artificiels aient été délaissés après le premier hiver de l'IA, les recherches continues menées par des scientifiques tels que Geoffrey Hinton, David Rumelhart et Ronald Williams au cours des années 1980 et 1990 sur l'algorithme de rétropropagation de l'erreur (Backpropagation) ont de nouveau attiré l'attention de la communauté scientifique. La rétropropagation a fourni une méthode mathématique extrêmement efficace pour entraîner des réseaux de neurones multicouches, devenant plus tard la pierre angulaire de la révolution de l'apprentissage profond (Deep Learning).
Le concept de « Big Data » et l'essor des processeurs GPU (Big Data and GPU Acceleration)
Au début du XXIe siècle, avec la généralisation d'Internet, des réseaux sociaux, des smartphones et des services numériques, la quantité de données générées à l'échelle mondiale a atteint un niveau sans précédent, donnant naissance au phénomène du Big Data (Big Data).
Puisque la précision et la capacité des modèles d'apprentissage automatique dépendent directement de leur alimentation par des données volumineuses et de haute qualité, l'avènement du Big Data est devenu le carburant essentiel au succès de ce domaine. Parallèlement, le déplacement de la charge de calcul des unités centrales (CPU) vers les processeurs graphiques (GPU) et le développement des techniques de calcul parallèle (Parallel Computing) ont permis de réduire le temps d'entraînement des modèles géants de plusieurs mois à quelques jours, voire quelques heures.
Impact stratégique de l'apprentissage automatique sur l'avenir des technologies (Strategic Impact of ML)
L'essor de l'apprentissage automatique a profondément transformé l'orientation et la philosophie de la recherche en IA. Cette mutation théorique et pratique est à l'origine du succès de nombreuses technologies que nous utilisons aujourd'hui au quotidien ; notamment :
Les systèmes de recommandation personnalisés : Les algorithmes d'analyse des préférences des utilisateurs sur des plateformes telles que Netflix et Spotify ;
La traduction linguistique en temps réel : Les systèmes multilingues de traitement du langage naturel ;
La reconnaissance vocale et visuelle : La vision par ordinateur et les technologies de vérification biométrique ;
La santé numérique et la médecine : Les analyses cliniques pour le diagnostic précoce des maladies ;
L'intelligence d'affaires et la cybersécurité : L'analyse automatique des risques et le filtrage des courriels indésirables.
Surtout, l'apprentissage automatique a servi de pont fondamental ayant rendu possible l'émergence de l'apprentissage profond (Deep Learning) et de l'IA générative (Generative AI), qui se trouvent aujourd'hui au sommet de l'innovation technologique mondiale.
La révolution de l'apprentissage profond : Le plus grand changement de paradigme de l'IA (The Deep Learning Revolution)
L'apprentissage profond (Deep Learning) est considéré comme l'un des tournants les plus majeurs et les plus transformateurs de l'histoire de l'intelligence artificielle. Bien que les fondements théoriques des réseaux de neurones artificiels (ANNs) aient été posés dès les années 1940 et 1950, l'insuffisance du matériel, le manque de données et la complexité mathématique de l'entraînement des réseaux profonds ont freiné le progrès pendant des décennies.
Au début du XXIe siècle, trois facteurs fondamentaux ont connu une convergence historique : l'explosion sans précédent des données numériques (Big Data), la puissance de calcul parallèle des puces graphiques (GPUs) et la mise au point de nouveaux algorithmes d'entraînement. La combinaison de ces trois éléments a fait de l'apprentissage profond le moteur principal de l'avancée mondiale en IA.
Changement de paradigme matériel : La transition du CPU au GPU
L'une des clés ingénieriques décisives de la révolution de l'apprentissage profond a été le transfert de la charge de calcul des unités centrales (CPU) vers les processeurs graphiques (GPU). Les puces GPU étaient initialement conçues pour les jeux vidéo en 3D et le rendu graphique ; cependant, les chercheurs ont découvert que ces puces pouvaient exécuter des milliers d'opérations matricielles mathématiques de manière simultanée et parallèle — précisément ce qu'exigeait l'entraînement des réseaux de neurones profonds.
L'entreprise NVIDIA a franchi une étape révolutionnaire en 2006 avec le lancement de l'architecture CUDA. Cette plateforme a permis aux chercheurs d'exploiter directement la puissance des puces GPU pour des calculs scientifiques intensifs et des modèles d'IA. Cette rupture matérielle a posé les bases du succès historique du modèle AlexNet en 2012 et du lancement officiel de la révolution de l'apprentissage profond.
Principes et architecture de l'apprentissage profond (Principles and Architecture of Deep Learning)
L'apprentissage profond est une branche avancée de l'apprentissage automatique reposant sur des réseaux de neurones profonds (Deep Neural Networks, DNNs). Ces réseaux sont constitués d'une multitude de couches cachées (Hidden Layers), où chaque couche apprend un niveau nouveau d'abstraction des caractéristiques à partir des données.
Par exemple, dans un système de vision par ordinateur dédié à la reconnaissance d'objets :
Les premières couches : Détectent uniquement les contours, les lignes et les formes géométriques de base ;
Les couches intermédiaires : Combinent des formes et des textures plus complexes ;
Les couches supérieures : Réalisent la représentation globale des objets (comme un visage humain ou un véhicule).
La différence méthodologique fondamentale entre l'apprentissage automatique classique et l'apprentissage profond réside dans ce principe :
L'approche classique : Exigeait que des experts humains définissent et extraient manuellement les caractéristiques (Features) des données ;
L'approche de l'apprentissage profond : Fonctionne selon le principe de l'apprentissage de bout en bout (End-to-End) ; c'est-à-dire que le modèle apprend et extrait ses caractéristiques hiérarchiques de manière totalement autonome directement à partir des données brutes (Raw Data).
C'est cette capacité supérieure d'apprentissage de représentations qui a permis à l'apprentissage profond d'obtenir des succès pratiques inégalés dans des domaines complexes tels que la vision par ordinateur, la reconnaissance vocale et le traitement du langage naturel.
La puissante résurgence des réseaux de neurones (Resurgence of Neural Networks)
Dans les années 1980, des scientifiques tels que Geoffrey Hinton, David Rumelhart et Ronald Williams ont développé et popularisé l'algorithme de rétropropagation de l'erreur (Backpropagation). Cette méthode offrait un procédé mathématique hautement efficace pour entraîner des réseaux de neurones multicouches. Cependant, la vitesse de calcul des ordinateurs et le volume de données disponibles à cette époque demeuraient encore insuffisants pour faire fonctionner efficacement de très grands réseaux dans la pratique.
Dans les années 2000, avec l'augmentation de la capacité de calcul des puces GPU et la disponibilité de vastes jeux de données sur Internet, les chercheurs se sont à nouveau tournés vers cette approche. Les paramètres des réseaux de neurones profonds ont ainsi pu être entraînés avec succès, posant les bases solides de la révolution de l'apprentissage profond (Deep Learning).
Le projet ImageNet : La percée historique de 2012 (The ImageNet Landmark: 2012)
La plupart des historiens de l'IA considèrent l'année 2012 comme le point de départ officiel de la révolution de l'apprentissage profond. Cette année-là, Alex Krizhevsky, Ilya Sutskever et Geoffrey Hinton ont conçu un réseau de neurones convolutif profond nommé AlexNet et ont participé à la compétition internationale ImageNet.
AlexNet a utilisé l'architecture des réseaux de neurones convolutifs (Convolutional Neural Network – CNN) ainsi que la puissance de calcul parallèle des puces GPU pour réduire de manière spectaculaire le taux d'erreur dans la reconnaissance d'images. Le modèle a surclassé tous ses concurrents basés sur des méthodes traditionnelles avec un écart considérable. Ce succès historique a prouvé que l'apprentissage profond était nettement supérieur aux approches classiques face à des problèmes complexes du monde réel ; en conséquence, les universités mondiales, les géants de la technologie et les investisseurs ont injecté des capitaux massifs dans ce domaine.
Architecture et évolution des modèles d'apprentissage profond (Evolution of Deep Learning Architectures)
Après le grand succès d'AlexNet, diverses architectures de réseaux de neurones spécialisées ont émergé, chacune déclenchant des révolutions dans des domaines spécifiques :
Les réseaux de neurones convolutifs (CNN) : Spécialement conçus pour la vision par ordinateur, la reconnaissance d'objets, l'analyse vidéo et l'imagerie médicale.
Les réseaux de neurones récurrents (RNN) : Utilisés pour le traitement de données séquentielles (Sequential) telles que le texte, la parole et les séries temporelles.
Les réseaux LSTM (Long Short-Term Memory) : Développés pour mieux traiter de longues séquences d'informations et de phrases sans perdre le contexte initial.
Les réseaux Transformers (Transformer Networks) : Présentés en 2017 par Google ; ils ont introduit le mécanisme d'auto-attention (Self-Attention). Cette architecture constitue la pierre angulaire des Grands Modèles de Langage (LLM) et de l'IA Générative (Generative AI) actuels.
Impacts pratiques et sociétaux de l'apprentissage profond (Practical Impact of Deep Learning)
L'apprentissage profond a engendré des transformations fondamentales dans des secteurs critiques et stratégiques :
La vision par ordinateur : La reconnaissance faciale sur smartphones, l'analyse d'images médicales (rayons X, IRM) et le pilotage des véhicules autonomes.
Le traitement du langage naturel : La traduction multilingue en temps réel, la synthèse automatique de longs textes et les agents conversationnels intelligents (tels que ChatGPT).
La reconnaissance vocale : Le fonctionnement des assistants vocaux intelligents et les technologies de conversion de la parole en texte.
La santé et la biomédecine : Le diagnostic précoce du cancer, l'analyse de données génomiques (ADN) et la découverte de nouvelles molécules médicamenteuses.
L'industrie et le commerce : La prévision de la demande du marché, le contrôle qualité automatisé et les recommandations personnalisées de produits.
Limites et défis de l'apprentissage profond (Limitations and Challenges)
Malgré tous ces grands succès, l'apprentissage profond présente des limites critiques :
Une forte dépendance aux données et des coûts de calcul élevés : L'entraînement de ces modèles nécessite des volumes massifs de données et des infrastructures matérielles extrêmement coûteuses et énergivores.
Le problème de la « boîte noire » (Black Box Problem) : La plupart des modèles profonds manquent de transparence en raison de leur complexité non linéaire interne. Le modèle fournit une réponse exacte, mais la logique interne qui sous-tend cette décision est extrêmement difficile à expliquer. Cela soulève de grands enjeux de confiance et de responsabilité dans des domaines vitaux tels que la médecine, le droit et la finance.
L'IA Générative (Generative AI) et ChatGPT : La nouvelle ère de la création de contenu
À la fin des années 2010 et au début des années 2020, l'intelligence artificielle est entrée dans une phase entièrement nouvelle connue sous le nom d'IA Générative (Generative AI). La différence fondamentale entre cette période et les époques précédentes réside dans le fait que les systèmes ne sont plus de simples outils d'analyse ou de classification de données ; ils peuvent désormais produire eux-mêmes des contenus entièrement nouveaux et originaux tels que du texte, des images, de l'audio, de la vidéo et du code informatique.
Qu'est-ce que l'IA Générative ? (What is Generative AI?)
L'IA Générative est une branche avancée de l'intelligence artificielle dans laquelle les modèles sont entraînés à comprendre des motifs, des distributions de probabilité et des relations cachées au sein de vastes jeux de données. Sur la base de ces apprentissages, ils génèrent de nouveaux contenus en réponse à des consignes d'entrée (Prompts).
Infrastructure matérielle et bond des Grands Modèles de Langage (LLM)
Le développement des grands modèles de langage et de l'IA générative aurait été impossible sans des progrès révolutionnaires dans le matériel informatique. L'entraînement de ces modèles géants exige des milliers de puces GPU de haute performance fonctionnant en parallèle.
Aujourd'hui, les puces avancées de la société NVIDIA (telles que les A100 et H100) sont considérées comme la colonne vertébrale de l'infrastructure mondiale d'IA. L'architecture CUDA de l'entreprise a permis aux chercheurs d'exploiter pleinement la puissance des GPU pour des calculs scientifiques intensifs et des modèles d'IA.
L'essor et les capacités des Grands Modèles de Langage (Large Language Models – LLM)
C'est sur la base de l'architecture Transformer que les Grands Modèles de Langage (LLM) se sont développés. Ces modèles sont entraînés sur des centaines de milliards de mots et de textes, ce qui leur confère la capacité de saisir les contextes complexes du langage naturel et les pensées humaines abstraites.
Les Grands Modèles de Langage peuvent accomplir avec succès les tâches suivantes :
Répondre de manière logique à des questions complexes ;
Rédiger de nouveaux textes et synthétiser de longs documents ;
Traduire automatiquement et de façon fluide entre différentes langues ;
Écrire, corriger (Debugging) et expliquer du code informatique ;
Corriger des erreurs grammaticales et sémantiques ;
Assister les êtres humains dans la recherche scientifique et la résolution de problèmes complexes.
Le modèle ChatGPT : Une nouvelle ère dans le dialogue homme-machine
ChatGPT est l'application d'IA générative la plus célèbre et la plus largement utilisée au monde. Développé par OpenAI, ce système repose sur la série de modèles GPT (Generative Pre-trained Transformer).
Lorsque la première version publique de ChatGPT a été mise en ligne le 30 novembre 2022, elle a séduit des millions d'utilisateurs à travers le monde en quelques jours seulement. Ce succès a prouvé que l'humanité était prête à adopter l'intelligence artificielle comme un outil quotidien pour apprendre, rédiger, coder et traduire.
Le secret du succès de ChatGPT : En plus du pré-entraînement (Pre-training) sur d'immenses volumes de données, le modèle utilise la technique de l'apprentissage par renforcement à partir du feedback humain (Reinforcement Learning from Human Feedback – RLHF). Cette technique a permis de rendre les réponses extrêmement précises, structurées et adaptées au style naturel de la conversation humaine.
Applications multidisciplinaires de l'IA Générative (Applications of Generative AI)
L'IA Générative a profondément transformé des secteurs clés :
Éducation : Rédaction de synthèses de cours, explication de concepts scientifiques difficiles et rôle de tuteur personnalisé.
Santé : Assistance aux médecins dans la rédaction de comptes rendus cliniques et l'analyse de données de patients.
Ingénierie logicielle : Aide aux développeurs pour l'écriture de code, le débogage et l'explication d'architectures logicielles.
Médias numériques : Rédaction d'ébauches d'articles, création de contenu et art numérique.
Commerce et marketing : Rédiger des textes publicitaires, automatiser le service client et analyser des stratégies de marché.
Art et design : Génération d'images créatives, de musique, de vidéos et de designs visuels.
Bibliographie académique (Academic Bibliography)
Russell, S., & Norvig, P. (2021). Artificial Intelligence: A Modern Approach (4th ed.). Pearson.
Turing, A. M. (1936). On Computable Numbers, with an Application to the Entscheidungsproblem. Proceedings of the London Mathematical Society, 2(42), 230–265.
Turing, A. M. (1950). Computing Machinery and Intelligence. Mind, 59(236), 433–460.
McCorduck, P. (2004). Machines Who Think: A Personal Inquiry into the History and Prospects of Artificial Intelligence (2nd ed.). A K Peters.
Nilsson, N. J. (2010). The Quest for Artificial Intelligence: A History of Ideas and Achievements. Cambridge University Press.
al-Jazarī, I. (1974). The Book of Knowledge of Ingenious Mechanical Devices (D. R. Hill, Trans.). D. Reidel Publishing Company.
Hill, D. R. (1998). Mechanical Engineering in the Medieval Near East. Scientific American, 264(5), 100–105.
Hill, D. R. (1991). Islamic Science and Engineering. Edinburgh University Press.
Encyclopaedia Britannica. al-Jazari.
Ceccarelli, M. (2004). Distinguished Figures in Mechanism and Machine Science. Springer.