Die Idee, eine Maschine zu erschaffen, die wie ein Mensch denken und Entscheidungen treffen kann, begann nicht erst mit dem Aufkommen moderner Computer; ihre Wurzeln reichen Tausende von Jahren zurück. Im Laufe der Menschheitsgeschichte haben zahlreiche Philosophen, Denker und Wissenschaftler versucht, die Fragen „Was ist Intelligenz?“ und „Kann Intelligenz künstlich erzeugt werden?“ zu ergründen. Diese theoretischen Fragestellungen bildeten das Fundament für die Ideen, die schließlich zur Entstehung der Künstlichen Intelligenz (KI) als eigenständige wissenschaftliche Disziplin führten.
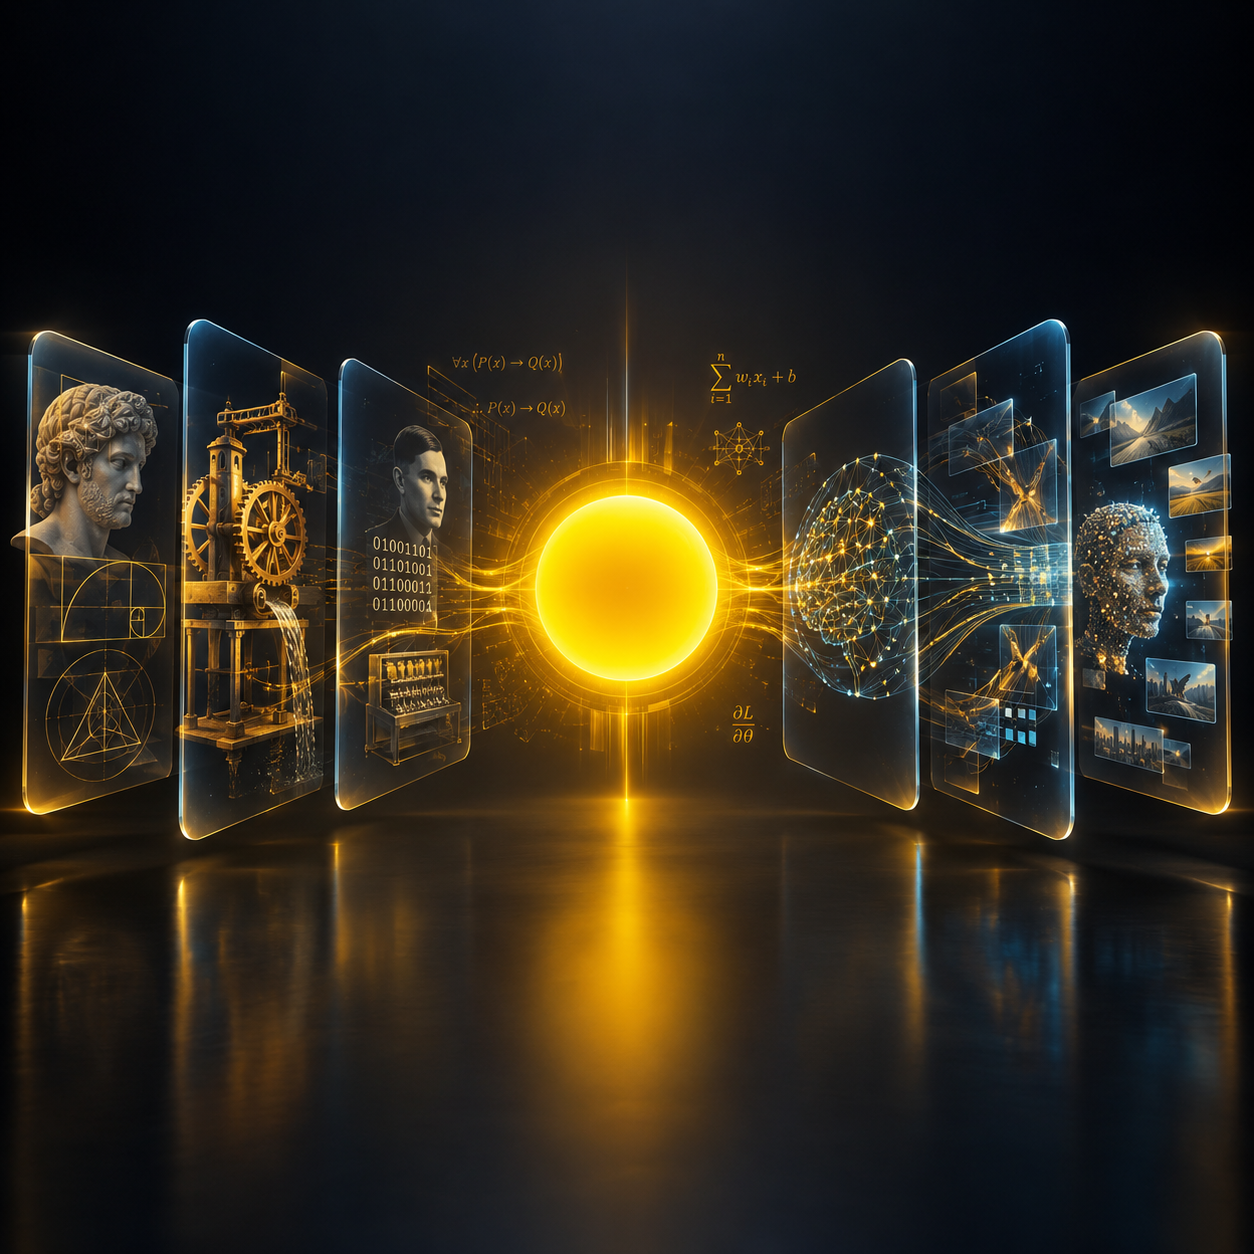
Im antiken Griechenland maßen Philosophen wie Platon (Plato) und Aristoteles (Aristotle) der Logik, dem strukturierten Denken und den Methoden des Erkenntnisgewinns große Bedeutung bei. Insbesondere Aristoteles entwickelte das erste formale Logiksystem und stellte die Regeln des deduktiven Schließens (Syllogismus) auf. Obwohl diese frühen Arbeiten nicht direkt zur Erschaffung einer künstlichen Intelligenz führten, begründeten sie das fundamentale Prinzip, dass menschliches Denken durch festgelegte Regeln und Prinzipien symbolisch beschrieben werden kann.
Im Mittelalter und in der frühen Neuzeit versuchten Mathematiker und Philosophen, Logik und Mathematik systematisch weiterzuentwickeln. Im 17. Jahrhundert schlug Gottfried Wilhelm Leibniz eine universelle Symbolsprache für Logik und Begriffe vor (Characteristica universalis). Er glaubte, dass, wenn alle Gedanken in mathematische Gesetze übersetzt werden könnten, zukünftige Rechenmaschinen komplexe Probleme mathematisch lösen könnten. Obwohl diese Idee zu jener Zeit praktisch nicht umsetzbar war, bildete sie ein wichtiges rationalistisches Fundament für die Künstliche Intelligenz.
Im 19. Jahrhundert kam es zu bedeutenden technologischen Fortschritten in der Rechentechnik und Automatisierung. Charles Babbage entwarf die „Analytische Maschine“ (Analytical Engine), die bereits viele Kernmerkmale moderner Computer wie Speicher (Memory), eine Recheneinheit (ALU) und Programmierbarkeit aufwies. Obwohl diese Maschine nie vollständig gebaut wurde, erkennen Wissenschaftshistoriker sie als den ersten Entwurf eines universellen Computers an.
Im selben Zeitraum stellte Ada Lovelace – die als erste Computerprogrammiererin der Welt gilt – eine äußerst weitsichtige Betrachtung an. Sie prognostizierte, dass zukünftige Rechenmaschinen nicht nur reine Zahlen berechnen, sondern auch Musik, Bilder und verschiedene unstrukturierte Datenformate verarbeiten könnten. Dieser Gedanke war für seine Zeit äußerst fortschrittlich und spielte später eine entscheidende Rolle bei der Erweiterung des Horizonts der Künstlichen Intelligenz.
Zu Beginn des 20. Jahrhunderts beschleunigte sich die Entwicklung der formalen Logik und der mathematischen Grundlagen erheblich. George Booles Arbeiten zur Booleschen Algebra sowie die nachfolgenden Forschungen von Gottlob Frege, Bertrand Russell und Alfred North Whitehead schufen ein solides Fundament für die mathematische Logik. Diese mathematischen Beiträge bewiesen, dass bestimmte Muster des menschlichen Denkens durch formale Regeln formuliert und von einer automatischen Maschine ausgeführt werden können.
Der größte paradigmatische Umbruch in dieser Phase ging aus den fundamentalen Arbeiten von Alan Turing hervor. Im Jahr 1936 stellte Turing in seiner historischen Arbeit On Computable Numbers, with an Application to the Entscheidungsproblem das theoretische Modell der „Turing-Maschine“ (Turing Machine) vor. Er bewies mathematisch, dass jeder logische Prozess, sofern er durch einen Algorithmus präzise beschrieben werden kann, von einer universellen Turing-Maschine ausgeführt werden kann. Dieses theoretische Konzept bildete das Fundament der Informatik und der Künstlichen Intelligenz.
Nach dem Zweiten Weltkrieg bot das Aufkommen elektronischer Computer eine neue Gelegenheit zur praktischen Umsetzung dieser Theorien. Im Jahr 1950 veröffentlichte Turing in der Zeitschrift Mind seinen wegweisenden Artikel Computing Machinery and Intelligence und stellte die historische Frage: „Können Maschinen denken?“ (Can machines think?). Zudem schlug er einen praktischen Test zur Bewertung des intelligenten Verhaltens eines Computersystems vor – das heute als „Turing-Test“ (Turing Test) bekannt ist.
Alle diese Fortschritte – von der antiken griechischen Logik und Leibniz’ mathematischer Philosophie über Babbages Analytische Maschine und Lovelaces Vision bis hin zu Turings Berechenbarkeitstheorie – lieferten das wissenschaftliche und intellektuelle Fundament für die Geburt der Künstlichen Intelligenz. Dieser Weg gipfelte schließlich im Jahr 1956 in der Dartmouth-Konferenz (Dartmouth Conference), auf der die Künstliche Intelligenz offiziell als eigenständige wissenschaftliche Disziplin begründet wurde.
Al-Dschazari und die frühe Automaten-Technik (Al-Jazari and Automata)
Jahrhunderte vor der offiziellen Geburt der Künstlichen Intelligenz legten Versuche, automatische Geräte und selbstlaufende Systeme zu bauen, eine wichtige praktische und ingenieurwissenschaftliche Grundlage für die spätere Entwicklung der Robotik und des Maschinenbaus. Einer der bedeutendsten Pioniere auf diesem Gebiet war Badi' az-Zaman Abū al-'Izz Ismā'īl ibn ar-Razzāz al-Dschazarī (Ismail al-Jazari, 1136–1206 n. Chr.). Al-Dschazari wirkte in Amed (dem heutigen Diyarbakır) im Norden Kurdistans und diente fast fünfzig Jahre lang als Chefingenieur am Hof der Artukiden-Dynastie.
Im Jahr 1206 n. Chr. vollendete al-Dschazari sein Meisterwerk der Ingenieurkunst, das Buch des Wissens von sinnreichen mechanischen Vorrichtungen (The Book of Knowledge of Ingenious Mechanical Devices). Das Werk gilt als eines der wichtigsten historischen Dokumente des Maschinenbaus; darin werden etwa 50 automatische mechanische Vorrichtungen mit präzisen technischen Erklärungen und Zeichnungen detailliert beschrieben. Zu seinen Erfindungen gehörten komplexe Wasseruhren, doppelt wirkende Hydraulikpumpen (Double-acting Pump), automatische Bedienstete, automatische Waschvorrichtungen und mechanische Musikensembles – die alle ohne menschliches Eingreifen über Strömungsmechanik, Schwerkraft und Nockenmechanismen (Cam Mechanism) automatisch funktionierten.
Viele Technikhistoriker betrachten al-Dschazari als einen der Väter des Maschinenbaus und der Automatisierungstheorie. Obwohl die Maschinen al-Dschazaris keine Künstliche Intelligenz im modernen Sinne besaßen – es fehlte ihnen an Lernfähigkeit, Entscheidungsfindung oder autonomem Verhalten –, gelten seine pioniereigenen Arbeiten als ein äußerst wichtiger historischer Meilenstein auf dem Weg zur Konstruktion menschenähnlicher Automaten und selbstständiger Systeme.
Alan Turing und der Turing-Test (Alan Turing and the Turing Test)
Alan Mathison Turing (1912–1954) gilt als einer der zentralen Begründer der Informatik und der Künstlichen Intelligenz. Seine Forschungen lieferten nicht nur einen theoretischen Rahmen für die Informatik, sondern eröffneten auch ein neues Paradigma zur Bewertung der Fähigkeit von Maschinen, menschliche Intelligenz nachzuahmen. Darüber hinaus spielte Turing während des Zweiten Weltkriegs eine entscheidende Rolle bei der Entschlüsselung der deutschen „Enigma“-Maschine, was den Sieg der Alliierten und die Entwicklung moderner Computer maßgeblich beeinflusste.
Das Modell der Turing-Maschine und die Grundlagen der Informatik
Im Jahr 1936 veröffentlichte Turing seine historische Arbeit On Computable Numbers, with an Application to the Entscheidungsproblem, in der er das abstrakte mathematische Modell der „Turing-Maschine“ einführte.
Dabei handelte es sich nicht um ein physisches Gerät, sondern um ein mathematisches Konstrukt, das zeigte, wie jeder geordnete logische Prozess in diskrete Schritte zerlegt werden kann. Die Bedeutung der Maschine lag im Beweis der algorithmischen Berechenbarkeit: Jedes Problem, das durch einen Algorithmus beschrieben werden kann, ist theoretisch durch eine universelle Turing-Maschine lösbar. Dieser Gedanke wurde zum Fundament der gesamten modernen Informatik.
„Können Maschinen denken?“
Im Jahr 1950 veröffentlichte Turing in der Philosophiezeitschrift Mind den einflussreichen Artikel Computing Machinery and Intelligence, der mit der prägnanten Frage begann:
„Can machines think?“ („Können Maschinen denken?“)
Turing war der Ansicht, dass der Begriff „denken“ philosophisch und semantisch zu vage sei. Daher schlug er vor, diese abstrakte Frage durch einen praktischen Verhaltenstest zur Bewertung der Leistungsfähigkeit von Computersystemen zu ersetzen.
Der Turing-Test (The Turing Test)
Dieser Test, den Turing ursprünglich als „Imitationsspiel“ (Imitation Game) bezeichnete, umfasst drei Hauptbeteiligte:
Einen menschlichen Teilnehmer (als Referenzmaßstab);
Ein Computer- bzw. KI-System (das versucht, menschliches Sprachverhalten zu simulieren);
Einen menschlichen Evaluator (Beurteiler) in einem separaten Raum, der unter Verblindung entscheidet.
Der Evaluator kommuniziert mit beiden Parteien ausschließlich über reine Textnachrichten. Wenn der Evaluator am Ende des Tests nicht zuverlässig unterscheiden kann, wer die Maschine und wer der Mensch ist, hat das KI-System den Test bestanden.
Akademische Anmerkung: Der Zweck dieses Tests besteht nicht darin zu beweisen, dass die Maschine über ein „Bewusstsein“ oder „Empfindungen“ verfügt, sondern lediglich darin zu messen, wie nahe ihr Sprach- und Dialogverhalten an das menschliche Äquivalent heranreicht.
Einfluss auf die Entwicklung der Künstlichen Intelligenz
Der Turing-Test wurde zu einem der einflussreichsten Standards in der Geschichte der Künstlichen Intelligenz. Er lieferte erstmals einen operationalisierbaren Rahmen zur Bewertung intelligenter Systeme. Diese Perspektive prägte die Forschung nach 1950 zutiefst und wurde zu einem zentralen Treiber für die Entwicklung von Chatbots, Frage-Antwort-Systemen und modernen großen Sprachmodellen (LLMs).
Im 21. Jahrhundert und mit dem Aufkommen fortschrittlicher Sprachmodelle ist die Diskussion um den Turing-Test erneut in den Fokus gerückt. Obwohl einige moderne Systeme in kurzen Dialogen ein verblüffend menschliches Verhalten zeigen, herrscht in der wissenschaftlichen Gemeinschaft Konsens darüber, dass das bloße Bestehen des Turing-Tests kein Beweis für das Vorhandensein einer Allgemeinen Künstlichen Intelligenz (AGI) oder eines Bewusstseins ist; denn ein System kann durch Mustersuche ein menschenähnliches Verhalten erzeugen, ohne echtes Verständnis zu besitzen.
Kritik und theoretische Grenzen
Trotz seines historischen Gewichts wurde der Turing-Test von Wissenschaftlern auch scharf kritisiert. Insbesondere der Philosoph John Searle zeigte mit seinem Gedankenexperiment des „Chinesischen Zimmers“ (Chinese Room), dass ein System Symbolverarbeitung strikt nach formalen Regeln (Syntax) ausführen kann, ohne irgendein tatsächliches Verständnis der Bedeutung (Semantik) zu besitzen. Zudem betont die Kognitionswissenschaft, dass menschliche Intelligenz nicht auf Sprachinteraktion beschränkt ist, sondern eng mit Umweltwahrnehmung, Entscheidungsfindung und der Interaktion mit der realen Welt verknüpft ist.
Die Dartmouth-Konferenz und die offizielle Geburt der KI (The Dartmouth Conference and the Formal Birth of AI)
Die meisten Computerhistoriker und die wissenschaftliche Gemeinschaft betrachten das Jahr 1956 als das offizielle Gründungsjahr der Künstlichen Intelligenz (Artificial Intelligence, AI) als eigenständige wissenschaftliche Disziplin. Im Sommer dieses Jahres fand am Dartmouth College in New Hampshire (USA) ein historisches Forschungsseminar statt, das später als „Dartmouth Summer Research Project on Artificial Intelligence“ bekannt wurde.
Diese Konferenz war der erste systematische Versuch, ein unabhängiges Wissenschaftsfeld zu etablieren, das sich speziell der Erforschung der Erzeugung intelligenten Verhaltens in Rechensystemen widmete.
Projektursprung und Pioniere (Origins and Pioneers)
Die Idee zu dieser Konferenz wurde ursprünglich von John McCarthy vorgeschlagen, der später als „Vater der Künstlichen Intelligenz“ bekannt wurde. Gemeinsam mit ihm verfassten Marvin Minsky, Nathaniel Rochester von IBM und Claude Shannon, der Begründer der Informationstheorie (Information Theory), den Antragstext.
Im Projektantrag wurde die folgende zentrale wissenschaftliche Hypothese formuliert:
„Jeder Aspekt des Lernens oder jedes andere Merkmal der Intelligenz kann im Prinzip so präzise beschrieben werden, dass eine Maschine gebaut werden kann, um ihn genau zu simulieren.“
Dieser Satz wurde zu einem zentralen intellektuellen Fundament für die Forscher jener Zeit; sie waren fest davon überzeugt, dass die menschliche Intelligenz durch Regeln, Algorithmen und Rechenleistung definiert und anschließend von Computern ausgeführt werden kann.
Die Geburt des Begriffs „Artificial Intelligence“ (Birth of the Term "Artificial Intelligence")
Eines der wichtigsten und historischsten Ergebnisse der Dartmouth-Konferenz war, dass John McCarthy erstmals offiziell den Begriff „Artificial Intelligence“ (Künstliche Intelligenz) auf akademischer Ebene einführte. Vor dieser Zeit wurden Forschungen auf diesem Gebiet unter verschiedenen Begriffen wie Kybernetik (Cybernetics), Automatentheorie (Automata Theory) oder komplexe Informationsverarbeitung (Complex Information Processing) geführt.
Die Wahl dieses neuen Begriffs hatte einen strategischen Grund: McCarthy wollte dieses Feld von anderen Wissenschaften abgrenzen und ihm eine unabhängige akademische Identität verleihen. In dieser Hinsicht war das Jahr 1956 nicht nur das Jahr einer Konferenz, sondern das offizielle Geburtsjahr einer neuen wissenschaftlichen Disziplin.
Hauptziele der Konferenz (Primary Objectives of the Conference)
Die an der Konferenz beteiligten Forscher prognostizierten mit großem Optimismus, dass sie die Hauptprobleme der menschlichen Intelligenz innerhalb weniger Jahre lösen könnten. Zu ihren wichtigsten Zielen gehörten:
Entwicklung automatischer Lernsysteme (Maschinelles Lernen);
Verstehen und Verarbeiten natürlicher Sprache (Natural Language Processing, NLP);
Formalisierung von Mechanismen zur Problemlösung und Entscheidungsfindung;
Formale Analyse logischen Denkens;
Entwicklung von Fähigkeiten zur Bild- und Objekterkennung;
Konstruktion einer Maschine, die ein dem Menschen vollkommen äquivalentes Verhalten an den Tag legen kann.
Obwohl die Forscher damals glaubten, diese Ziele in naher Zukunft zu erreichen, zeigten spätere Entwicklungen, dass die menschliche Intelligenz weitaus komplexer und tiefgründiger ist, als sie es sich zu Beginn vorgestellt hatten.
Akademische Wirkung und institutionelle Unterstützung (Academic Impact and Institutional Support)
Obwohl die Dartmouth-Konferenz selbst nicht direkt zu einem großen technischen Durchbruch führte, war ihr Einfluss auf die Ausrichtung der Informatik beispiellos. Nach diesem Ereignis begannen führende Universitäten weltweit mit dem Aufbau spezieller KI-Laboratorien, darunter das Massachusetts Institute of Technology (MIT), die Stanford University und die Carnegie Mellon University.
Gleichzeitig stellten die US-Regierung und Bundesbehörden wie die DARPA enorme finanzielle Mittel für Forschungen in diesem neuen Bereich bereit. Diese finanzielle Unterstützung wurde zum primären Motor für die Entwicklung der ersten intelligenten Programme und den Fortschritt des Maschinellen Lernens.
Frühe Pionierleistungen: 1950er–1960er Jahre (Early Breakthroughs: 1950s–1960s)
In der zweiten Hälfte der 1950er und zu Beginn der 1960er Jahre entstanden mehrere bahnbrechende Projekte, von denen die wichtigsten waren:
Logic Theorist (1956): Entwickelt von Allen Newell und Herbert A. Simon; gilt als das erste KI-Programm der Geschichte und besaß die Fähigkeit, Symbole und logische Rätsel zu lösen.
General Problem Solver (GPS): Ein pionierhafter Versuch, ein universelles System zur Lösung logischer Probleme zu schaffen.
Die Programmiersprache LISP (1958): Von John McCarthy selbst erfunden; diente über Jahrzehnte hinweg als primäre Grundlagensprache für die gesamte weltweite KI-Forschung.
Diese Erfolge bewiesen trotz ihrer Begrenzungen, dass Computer Aufgaben des logischen Denkens erfolgreich ausführen können.
KI-Winter (AI Winters)
Nach dem starken Start der Künstlichen Intelligenz Ende der 1950er und Anfang der 1960er Jahre waren viele Forscher und Förderinstitutionen optimistisch, dass Computer innerhalb weniger Jahre die meisten intelligenten Aufgaben des Menschen übernehmen könnten. Diese Erwartungen deckten sich jedoch nicht mit den tatsächlichen Leistungsfähigkeiten der damaligen Technologie.
Das Ergebnis dieser großen Lücke zwischen Erwartung und Realität war, dass finanzielle Unterstützung, öffentliches Vertrauen und Forschungsaktivitäten wiederholt dramatisch einbrachen. Diese Dämpfungsphasen in der Technologiegeschichte sind als „KI-Winter“ (AI Winters) bekannt.
Der Begriff „KI-Winter“ bezeichnet historische Zyklen, in denen sowohl die finanzielle Förderung als auch die öffentlichen Erwartungen drastisch zurückgingen; dies lag daran, dass die praktischen Ergebnisse nicht das Niveau der großen Vorhersagen erreichten, die Forscher und Unternehmen gemacht hatten. Diese Winter gehörten zu den wichtigsten Wendepunkten in der Geschichte der KI, da sie das Fachgebiet zwangen, seine theoretischen Ansätze und Methodiken neu zu evaluieren.
Der erste KI-Winter: 1970er Jahre (The First AI Winter: 1970s)
Der erste KI-Winter begann Ende der 1960er und Anfang der 1970er Jahre. Obwohl frühe intelligente Programme wie Logic Theorist, GPS und ELIZA die Aufmerksamkeit der Medien und Wissenschaftskreise auf sich gezogen hatten, waren ihre Fähigkeiten extrem begrenzt. Die meisten dieser Systeme funktionierten nur in einer hochgradig angepassten Laborumgebung und versagten bei der Bewältigung komplexer Probleme der realen Welt.
Das Buch Perceptrons (1969): In diesem Jahr veröffentlichten Marvin Minsky und Seymour Papert ihr berühmtes Buch Perceptrons, in dem sie die mathematischen Grenzen einschichtiger künstlicher neuronaler Netze aufzeigten. Obwohl ihre Kritik wissenschaftlich vollkommen korrekt war, interpretierten viele Förderer dies so, dass neuronale Netze keinerlei Zukunft hätten; dies führte zu einer Einstellung der Forschungen in diesem Bereich für fast zwei Jahrzehnte.
Der Lighthill-Report (1973): In diesem Jahr veröffentlichte die britische Regierung einen strategischen Bewertungsbericht namens Lighthill Report. Er wurde von dem Mathematiker Sir James Lighthill verfasst und kritisierte scharf die Grenzen der KI und den Mangel an praktischen Erfolgen. Nach der Veröffentlichung dieses Berichts wurden den meisten KI-Projekten in Großbritannien die finanziellen Mittel gestrichen, was auch international große negative Auswirkungen hatte.
Rückkehr neuer Hoffnung: 1980er Jahre (The Revival of Hope: 1980s)
In den 1980er Jahren zog die Künstliche Intelligenz vor allem durch den kommerziellen Erfolg von Expertensystemen (Expert Systems) erneut das Interesse von Unternehmen und Regierungen auf sich. Diese Systeme bündelten das Wissen und die Erfahrung von Experten auf einem bestimmten Gebiet und nutzten es für Entscheidungsfindungen und Problemlösungen. Giganten wie die Digital Equipment Corporation (DEC) und IBM investierten gewaltige Summen in diesen Bereich.
Gleichzeitig startete die japanische Regierung ihr wichtiges nationales Projekt namens „Fifth Generation Computer Systems“ (FGCS), das darauf abzielte, hochintelligente Computer zur Lösung extrem komplexer Probleme zu bauen. Diese Schritte schufen eine neue Welle des Optimismus für die Zukunft der Künstlichen Intelligenz.
Der zweite KI-Winter: Ende der 1980er und Anfang der 1990er Jahre (The Second AI Winter: Late 1980s–Early 1990s)
Trotz des anfänglichen Optimismus stieß die Künstliche Intelligenz Ende der 1980er Jahre erneut an eine harte technische und ingenieurwissenschaftliche Grenze. Es stellte sich heraus, dass Expertensysteme (Expert Systems) extrem hohe Entwicklungs- und Wartungskosten verursachten, die Aktualisierung ihrer Wissensbasis (Knowledge Base) außerordentlich komplex war und ihre Anpassungsfähigkeit in dynamischen, sich verändernden Umgebungen stark limitiert blieb.
Erhöht wurde dieser Druck durch das exponentielle Wachstum des Marktes für Personal Computer (PCs). Viele Unternehmen und Institutionen wandten sich kostengünstigeren, allgemeinen Hardware- und Softwarelösungen zu, die keine teure, spezialisierte KI-Hardware benötigten. Infolgedessen gerieten zahlreiche kommerzielle KI-Unternehmen in Schieflage, und die finanzielle Förderung von Forschungsprojekten brach erneut ein. Dieser Abschnitt ging als „zweiter KI-Winter“ in die Geschichte der Technologie ein.
Hauptursachen für das Entstehen der KI-Winter (Key Causes of AI Winters)
Eine Reihe grundlegender, struktureller Faktoren führte nacheinander zum Eintreten dieser Stagnationsphasen:
Unerfüllbare Erwartungen und übertriebener Optimismus: Die vorschnelle Behauptung, innerhalb kürzester Zeit eine menschenähnliche Allgemeine Künstliche Intelligenz (AGI) zu erreichen.
Physikalische Grenzen der Rechenleistung: Die geringe Verarbeitungsgeschwindigkeit und der begrenzte Speicher der damaligen Computer im Vergleich zum Umfang komplexer kognitiver Aufgaben.
Mangel an adäquaten Datensätzen: Das Fehlen von qualitativ hochwertigen und hinreichend großen Datensätzen zum Trainieren der Modelle.
Theoretische Grenzen früher Algorithmen: Das Fehlen fortschrittlicher Algorithmen zur automatischen Merkmalsextraktion auf hoher Abstraktionsebene.
Kluft zwischen Laborumgebung und Realität: Das tiefgreifende Diskrepanzverhalten zwischen Systemen in kontrollierten Testumgebungen und unter den Unwägbarkeiten der realen Welt.
Ernüchterung der Investoren: Die Kürzung von Forschungsetats durch Regierungen und Konzerne nach dem Ausbleiben großer Versprechungen.
Der Aufstieg des Maschinellen Lernens (The Rise of Machine Learning)
Nach den Erfahrungen der KI-Winter erkannten Wissenschaftler, dass der in der Frühphase dominierende klassische Ansatz – der weitgehend auf menschlich geschriebenen regelbasierten Systemen (Rule-Based Systems) beruhte – an deutliche theoretische Grenzen stieß. Für die meisten komplexen Phänomene der realen Welt war das manuelle Ausformulieren aller Regeln und Entscheidungspfade schlicht unmöglich, da Umgebungen, Kontexte und Datenströme ständiger Dynamik unterliegen.
Aus dieser Erkenntnis heraus entstand ein neuer, revolutionärer Forschungsparadigma: das Maschinelle Lernen (Machine Learning, ML). In diesem neuen Ansatz warten Computer nicht mehr auf explizit programmierte Anweisungen, sondern lernen direkt aus Daten, Muster und komplexe Zusammenhänge zu erkennen und Aufgaben eigenständig auszuführen.
Hardware-Fortschritte und der Sprung der Rechenleistung (Hardware Advances)
Die Entwicklung des Maschinellen Lernens hing keineswegs nur von neuen Algorithmen ab; die Hardware-Entwicklung wirkte als entscheidender Katalysator. In den 1990er und frühen 2000er Jahren führten Architektursprünge bei den zentralen Steuereinheiten (CPUs) durch Halbleiterkonzerne wie Intel und AMD zu einer drastischen Erhöhung der Verarbeitungsgeschwindigkeit. Dieser Rechenleistungssprung ermöglichte das Testen komplexerer statistischer Modelle und die Analyse deutlich größerer Datenmengen.
Konzept und Definition des Maschinellen Lernens (Concept and Definition of Machine Learning)
Das Maschinelle Lernen ist ein zentraler Teilbereich der Künstlichen Intelligenz mit dem Ziel, Software und Algorithmen zu entwickeln, die automatisch aus Daten lernen, verborgene Muster erkennen und präzise Vorhersagen oder Entscheidungen treffen können – ohne dass der Programmierer jeden Regelfall explizit im Code vorgeben muss.
Eine der klassischsten und am häufigsten zitierten Definitionen wurde 1959 von dem KI-Pionier Arthur Samuel formuliert:
„Maschinelles Lernen ist das Forschungsgebiet, das Computern die Fähigkeit verleiht zu lernen, ohne explizit dafür programmiert zu sein.“
Haupttreiber des Durchbruchs des Maschinellen Lernens (Drivers of Machine Learning Adoption)
Ende der 1980er und vor allem im Laufe der 1990er Jahre führten fundamentale Entwicklungen zur raschen Verbreitung des Maschinellen Lernens:
Die Explosion digitaler Daten: Die Entstehung der ersten großen, standardisierten Datensätze (Datasets).
Leistungssteigerung der Hardware: Höhere Verarbeitungsgeschwindigkeiten und sinkende Speicherkosten.
Fortschritte in den Grundlagenwissenschaften: Die vertiefte Integration von Mathematischer Statistik, Wahrscheinlichkeitstheorie (Probability Theory) und Optimierungstheorie in die Informatik.
Markt- und Industrieanforderungen: Die starke kommerzielle Nachfrage nach Systemen zur Vorhersage, Datenklassifizierung sowie Bild- und Spracherkennung.
Diese Faktoren veranlassten Forscher dazu, statt tausender Zeilen starrer Regeln flexible statistische Modelle zu bauen, die eigenständig nach der optimalen Lösung in den Daten suchen.
Die drei Hauptparadigmen des Maschinellen Lernens (Major Paradigms of Machine Learning)
Das Maschinelle Lernen unterteilt sich auf theoretischer und praktischer Ebene im Wesentlichen in drei Grunddisziplinen:
Überwachtes Lernen (Supervised Learning): Das Modell wird auf einem Datensatz trainiert, der explizite Ziel-Labels (Labels) enthält. Das Hauptziel besteht darin, die Abbildungsfunktion zwischen Eingabemerkmalen und Ausgabeseite zu erlernen, um Vorhersagen für völlig neue Daten zu treffen.
Typische Anwendungen: Immobilienpreisschätzungen, Spam-E-Mail-Filterung, Krankheitsdiagnostik anhand medizinischer Bilddaten.
Unüberwachtes Lernen (Unsupervised Learning): Den dem Modell übergebenen Trainingsdaten fehlen vordefinierte Labels oder Zielantworten. Der Algorithmus versucht eigenständig, verborgene Strukturen, Muster und Clustereigenschaften (Clusters) innerhalb der Daten zu entdecken.
Typische Anwendungen: Kundensegmentierung nach Verhalten (Customer Segmentation), Anomalie- und Betrugserkennung (Anomaly Detection), hochdimensionale Datenreduktion (Dimensionality Reduction).
Bestärkendes Lernen (Reinforcement Learning): Ein Agent (Agent) lernt durch Versuch und Irrtum (Trial and Error) innerhalb einer dynamischen Umgebung. Für korrekte Aktionen erhält er eine Belohnung (Reward), für Fehler eine Bestrafung (Penalty). Im Laufe der Zeit entwickelt der Agent eine optimale Verhaltensstrategie zur Maximierung der kumulierten Belohnung.
Typische Anwendungen: Komplexe Spielentscheidungen (Schach, Go), Robotersteuerung, autonome Fahrzeuge, automatisiertes Netzwerkmanagement.
Algorithmetische Evolution und die Wiederbelebung neuronaler Netze (Algorithmic Evolution and Resurgence of Neural Networks)
In den 1990er und 2000er Jahren reiften mehrere fortschrittliche statistische Algorithmen heran, die das Fundament des modernen Maschinellen Lernens bildeten; darunter Entscheidungsbäume (Decision Trees), Random Forests (Random Forests), Support-Vektor-Maschinen (Support Vector Machines, SVM), Naïve Bayes und k-Nächste-Nachbarn (k-Nearest Neighbors, k-NN). Diese Verfahren erzielten in den Bereichen Wirtschaft, Medizin und Verarbeitung natürlicher Sprache große praktische Erfolge.
Gleichzeitig – obwohl künstliche neuronale Netze nach dem Ersten KI-Winter in den Hintergrund getreten waren – lenkten die fortlaufenden Forschungen von Wissenschaftlern wie Geoffrey Hinton, David Rumelhart und Ronald Williams in den 1980er und 1990er Jahren zum Backpropagation-Algorithmus (Backpropagation) die Aufmerksamkeit der Fachwelt erneut auf neuronale Netze. Der Backpropagation-Algorithmus bot eine mathematisch hochgradig effiziente Methode zum Trainieren mehrschichtiger neuronaler Netze und wurde später zum zentralen Baustein der Deep-Learning-Revolution (Deep Learning).
Das Konzept von „Big Data“ und der Aufstieg von GPU-Chips (Big Data and GPU Acceleration)
Zu Beginn des 21. Jahrhunderts erreichte die weltweite Datenmenge durch die Verbreitung des Internets, sozialer Netzwerke, Smartphones und digitaler Dienste ein nie dagewesenes Ausmaß, was als Big Data (Big Data) bekannt wurde.
Da die Genauigkeit und Kapazität von Modellen des Maschinellen Lernens direkt von der Befeuerung mit hochqualitativen Daten abhängen, wurde das Aufkommen von Big Data zum Haupttreibstoff für den Erfolg dieses Fachgebiets. Parallel dazu führte die Verlagerung der Rechenlast von zentralen Steuereinheiten (CPUs) auf Grafikprozessoren (GPUs) und die Entwicklung von Techniken zur parallelen Datenverarbeitung (Parallel Computing) dazu, dass die Trainingszeit riesiger Modelle von mehreren Monaten auf wenige Tage oder gar Stunden reduziert werden konnte.
Strategische Auswirkungen des Maschinellen Lernens auf die Zukunft der Technologie (Strategic Impact of ML)
Der Aufstieg des Maschinellen Lernens veränderte die Ausrichtung und Philosophie der KI-Forschung grundlegend. Dieser theoretische und praktische Wandel führte zum Erfolg vieler Technologien, die wir heute im Alltag nutzen; darunter:
Personalisierte Empfehlungssysteme: Nutzerinteressen-Algorithmen auf Plattformen wie Netflix und Spotify;
Echtzeit-Sprachübersetzung: Mehrsprachige Systeme zur Verarbeitung natürlicher Sprache;
Sprach- und Bilderkennung: Computer-Vision- und biometrische Verifikationsverfahren;
Digitale Gesundheit und Medizin: Klinische Analysen zur Früherkennung von Krankheiten;
Business Intelligence und Cybersicherheit: Automatische Risikoanalysen und Spam-Filterung.
Vor allem aber fungierte das Maschinelle Lernen als Brücke, die den Weg für die Entstehung von Deep Learning (Deep Learning) und Generativer KI (Generative AI) ebnete, die heute an der Spitze der globalen Technologie stehen.
Die Deep-Learning-Revolution: Der größte Paradigmenwechsel der KI (The Deep Learning Revolution)
Deep Learning (Deep Learning) gilt als einer der wichtigsten und transformativsten Wendepunkte in der Geschichte der Künstlichen Intelligenz. Obwohl die theoretischen Grundlagen künstlicher neuronaler Netze (ANNs) bereits in den 1940er und 1950er Jahren gelegt wurden, verhinderten die Unzulänglichkeit der Hardware, der Mangel an Daten und die mathematische Komplexität des Trainings tiefer Netze über Jahrzehnte hinweg den Fortschritt.
Zu Beginn des 21. Jahrhunderts kam es zu einem historischen Zusammentreffen dreier fundamentaler Faktoren: dem präzedenzlosen Ausbruch digitaler Daten (Big Data), der parallelen Rechenleistung von Grafikchips (GPUs) und der Entwicklung neuer Trainingsalgoritmik. Die Kombination dieser drei Elemente machte Deep Learning zum primären Motor des globalen KI-Fortschritts.
Paradigmenwechsel in der Hardware-Philosophie: Der Übergang von CPU zu GPU
Einer der entscheidenden ingenieurtechnischen Schlüssel der Deep-Learning-Revolution war die Verlagerung der Berechnungslast von zentralen Steuereinheiten (CPUs) auf Grafikprozessoren (GPUs). GPU-Chips wurden ursprünglich für 3D-Computerspiele und Grafik-Rendering entwickelt; Forscher entdeckten jedoch, dass diese Chips Tausende mathematischer Matrixoperationen gleichzeitig und parallel ausführen können – genau das, was das Training tiefer neuronaler Netze erforderte.
Das Unternehmen NVIDIA vollzog 2006 mit der Einführung der CUDA-Architektur einen revolutionären Schritt. Diese Plattform ermöglichte es Forschern, die Leistung von GPU-Chips direkt für mathematisch intensive wissenschaftliche Berechnungen und KI-Modelle zu nutzen. Dieser hardwareseitige Durchbruch legte den Grundstein für den historischen Erfolg des AlexNet-Modells im Jahr 2012 und den offiziellen Beginn der Deep-Learning-Revolution.
Grundprinzipien und Architektur von Deep Learning (Principles and Architecture of Deep Learning)
Deep Learning ist ein fortgeschrittener Teilbereich des Maschinellen Lernens, der auf tiefen neuronalen Netzen (Deep Neural Networks, DNNs) basiert. Diese Netze bestehen aus einer Vielzahl verdeckter Schichten (Hidden Layers), wobei jede Schicht eine neue Abstraktionsebene von Merkmalen aus den Daten erlernt.
Beispielsweise in einem Computer-Vision-System zur Objekterkennung:
Erste Schichten: Erkennen lediglich Kanten, Linien und grundlegende geometrische Formen;
Mittlere Schichten: Kombinieren komplexere Formen und Texturen;
Höhere Schichten: Realisieren die ganzheitliche Repräsentation von Objekten (wie ein menschliches Gesicht oder ein Fahrzeug).
Der fundamentale methodische Unterschied zwischen klassischem Maschinellem Lernen und Deep Learning ist folgender:
Klassischer Ansatz: Erforderte, dass menschliche Experten die Merkmale (Features) der Daten manuell vordefinierten und extrahierten;
Deep-Learning-Ansatz: Arbeitet nach dem Prinzip des End-to-End-Lernens (End-to-End); das Modell erlernt und extrahiert seine hierarchischen Merkmale völlig autonom direkt aus den unstrukturierten Rohdaten (Raw Data).
Gerade diese überlegene Fähigkeit zur Repräsentationslernen ermöglichte Deep Learning beispiellose praktische Erfolge in extrem komplexen Bereichen wie Computer Vision, Spracherkennung und Verarbeitung natürlicher Sprache.
Die starke Rückkehr neuronaler Netze (Resurgence of Neural Networks)
In den 1980er Jahren entwickelten und verbreiteten Wissenschaftler wie Geoffrey Hinton, David Rumelhart und Ronald Williams den Backpropagation-Algorithmus (Backpropagation). Diese Methode bot ein mathematisch hochgradig effizientes Verfahren zum Trainieren mehrschichtiger neuronaler Netze. Allerdings reichten die Verarbeitungsgeschwindigkeit der Computer und die Menge der verfügbaren Daten in jener Ära noch nicht aus, um extrem große Netze in der Praxis effizient zu betreiben.
In den 2000er Jahren, mit der steigenden Rechenkapazität von GPU-Chips und der Verfügbarkeit großer Datensätze im gesamten Internet, wandten sich Forscher erneut diesem Ansatz zu. Dadurch konnten die Parameter tiefer neuronaler Netze erfolgreich trainiert werden, was das solide Fundament für die Deep-Learning-Revolution (Deep Learning) legte.
Das ImageNet-Projekt: Der historische Durchbruch von 2012 (The ImageNet Landmark: 2012)
Die meisten KI-Historiker betrachten das Jahr 2012 als das offizielle Startjahr der Deep-Learning-Revolution. In diesem Jahr entwickelten Alex Krizhevsky, Ilya Sutskever und Geoffrey Hinton ein tiefes faltungsbasiertes neuronales Netz namens AlexNet und nahmen am internationalen ImageNet-Wettbewerb teil.
AlexNet nutzte die Architektur faltungsbasierter neuronaler Netze (Convolutional Neural Network – CNN) sowie die parallele Rechenleistung von GPU-Chips, um die Fehlerrate bei der Bilderkennung drastisch zu senken. Das Modell ließ alle auf traditionellen Methoden basierenden Konkurrenten mit großem Abstand hinter sich. Dieser historische Erfolg bewies, dass Deep Learning bei komplexen Problemen der realen Welt den klassischen Ansätzen weit überlegen ist; in der Folge investierten globale Universitäten, Technologiekonzerne und Investoren gewaltige Kapazitäten in diesen Bereich.
Architektur und Entwicklung von Deep-Learning-Modellen (Evolution of Deep Learning Architectures)
Nach dem großen Erfolg von AlexNet reiften verschiedene spezialisierte neuronale Netzarchitekturen heran, die jeweils in einem bestimmten Bereich Revolutionen auslösten:
Faltungsbasierte neuronale Netze (CNNs): Speziell entwickelt für Computer Vision, Objekterkennung, Videoanalyse und medizinische Bildverarbeitung.
Rekurrente neuronale Netze (RNNs): Genutzt zur Verarbeitung sequenzieller Daten (Sequential) wie Text, Sprache und Zeitreihen.
LSTM-Netzwerke (Long Short-Term Memory): Entwickelt zur besseren Verarbeitung langer Informationssequenzen und Sätze, ohne den ursprünglichen Kontext zu verlieren.
Transformer-Netzwerke (Transformer Networks): 2017 von Google vorgestellt; führten den Selbst-Aufmerksamkeits-Mechanismus (Self-Attention) ein. Diese Architektur bildet den Grundstein der heutigen Großen Sprachmodelle (LLMs) und der Generativen KI (Generative AI).
Praktische und gesellschaftliche Auswirkungen von Deep Learning (Practical Impact of Deep Learning)
Deep Learning hat in kritischen und sensiblen Bereichen fundamentale Transformationen bewirkt:
Computer Vision: Gesichtserkennung auf Smartphones, Analyse medizinischer Röntgen- und MRT-Bilder sowie Steuerung autonomer Fahrzeuge.
Verarbeitung natürlicher Sprache: Mehrsprachige Echtzeitübersetzung, automatische Textzusammenfassung und intelligente Chatbots (wie ChatGPT).
Spracherkennung: Betrieb intelligenter Sprachassistenten und Technologien zur Umwandlung von Sprache in Text.
Gesundheitswesen und Biomedizin: Früherkennung von Krebs, Genomdatenanalyse (DNA) und Entdeckung neuer Arzneimittelmoleküle.
Industrie und Handel: Marktnachfrageprognosen, automatische Qualitätskontrolle und personalisierte Produktempfehlungen.
Grenzen und Herausforderungen von Deep Learning (Limitations and Challenges)
Trotz all dieser großen Erfolge weist Deep Learning kritische Einschränkungen auf:
Hohe Datenabhängigkeit und enorme Rechenkosten: Das Trainieren dieser Modelle erfordert gewaltige Datenmengen und eine extrem teure, energieintensive Hardware-Infrastruktur.
Das „Black-Box“-Problem (Black Box Problem): Die meisten tiefen Modelle sind aufgrund ihrer komplexen inneren Nichtlinearität nicht transparent. Das Modell liefert eine korrekte Antwort, aber die innere Logik hinter dieser Entscheidung ist extrem schwer zu erklären. Dies wirft große Vertrauens- und Rechenschaftsfragen in lebenswichtigen Bereichen wie Medizin, Recht und Finanzen auf.
Generative KI (Generative AI) und ChatGPT: Das neue Zeitalter der Inhaltserstellung
Ende der 2010er und Anfang der 2020er Jahre trat die Künstliche Intelligenz in eine völlig neue Phase ein, die als Generative KI (Generative AI) bekannt ist. Der fundamentale Unterschied dieser Phase zu früheren Epochen besteht darin, dass die Systeme nicht mehr reine Werkzeuge zur Datenanalyse oder -klassifizierung sind; vielmehr können sie selbst völlig neue, originäre Inhalte wie Text, Bild, Audio, Video und Programmcode erzeugen.
Was ist Generative KI? (What is Generative AI?)
Generative KI ist ein fortgeschrittener Teilbereich der Künstlichen Intelligenz, in dem Modelle darauf trainiert werden, Muster, Wahrscheinlichkeitsverteilungen und verborgene Zusammenhänge in riesigen Datensätzen zu erlernen. Basierend auf dem Erlernten erzeugen sie als Antwort auf Eingabeaufforderungen (Prompts) neue Inhalte.
Hardware-Infrastruktur und der Sprung Großer Sprachmodelle (LLMs)
Die Entwicklung Großer Sprachmodelle und Generativer KI wäre ohne revolutionäre Fortschritte in der Computer-Hardware unmöglich gewesen. Das Trainieren dieser riesigen Modelle erfordert Tausende von Hochleistungs-GPU-Chips, die parallel zusammenarbeiten.
Heute gelten die fortschrittlichen Chips des Unternehmens NVIDIA (wie A100 und H100) als das Rückgrat der globalen KI-Infrastruktur. Die CUDA-Architektur des Unternehmens ermöglichte es Forschern, die Leistung von GPUs für mathematisch intensive wissenschaftliche Berechnungen und KI-Modelle voll auszuschöpfen.
Der Aufstieg und die Fähigkeiten Großer Sprachmodelle (Large Language Models – LLMs)
Auf der Grundlage der Transformer-Architektur entwickelten sich Große Sprachmodelle (LLMs). Diese Modelle werden mit Hunderten Milliarden Wörtern und Texten trainiert, wodurch sie die Fähigkeit erlangen, komplexe Kontexte natürlicher Sprache und abstrakte menschliche Gedanken zu erfassen.
Große Sprachmodelle können folgende Aufgaben erfolgreich ausführen:
Logische Beantwortung komplexer Fragen;
Verfassen neuer Texte und Zusammenfassen langer Dokumente;
Flüssige automatische Übersetzung zwischen verschiedenen Sprachen;
Schreiben, Debuggen (Debugging) und Erklären von Programmcode;
Korrektur grammatikalischer und semantischer Fehler;
Unterstützung von Menschen bei wissenschaftlicher Forschung und komplexer Problemlösung.
Das ChatGPT-Modell: Eine neue Ära im Mensch-Maschine-Dialog
ChatGPT ist die bekannteste und am weitesten verbreitete Anwendung Generativer KI weltweit. Das von OpenAI entwickelte System basiert auf der Modellreihe GPT (Generative Pre-trained Transformer).
Als die erste öffentliche Version von ChatGPT am 30. November 2022 veröffentlich wurde, erreichte sie innerhalb weniger Tage Millionen von Nutzern weltweit. Dieser Erfolg bewies, dass die Menschheit bereit ist, Künstliche Intelligenz als tägliches Werkzeug zum Lernen, Schreiben, Programmieren und Übersetzen zu übernehmen.
Das Erfolgsgeheimnis von ChatGPT: Neben dem Vortraining (Pre-training) auf riesigen Datenmengen nutzt das Modell die Technik des Bestärkenden Lernens durch menschliches Feedback (Reinforcement Learning from Human Feedback – RLHF). Diese Technik führte dazu, dass die Antworten extrem präzise, strukturiert und an den natürlichen menschlichen Dialogstil angepasst sind.
Multidisziplinäre Anwendungen Generativer KI (Applications of Generative AI)
Generative KI hat Schlüsselbranchen grundlegend transformiert:
Bildung: Erstellung von Lektürezusammenfassungen, Erklärung schwieriger wissenschaftlicher Konzepte und Funktion als personalisierter Tutor.
Gesundheitswesen: Unterstützung von Ärzten beim Verfassen klinischer Berichte und bei der Analyse von Patientendaten.
Software-Engineering: Unterstützung von Entwicklern beim Schreiben von Code, Debugging und Erklären von Code-Architekturen.
Digitale Medien: Erstellung von Nachrichtenentwürfen, Inhaltserstellung und digitale Kunst.
Wirtschaft und Marketing: Erstellung von Werbetexten, automatisierter Kundenservice und Analyse von Marktstrategien.
Kunst und Design: Erzeugung kreativer Bilder, Musik, Videos und visueller Designs.
Literaturverzeichnis (Academic Bibliography)
Russell, S., & Norvig, P. (2021). Artificial Intelligence: A Modern Approach (4th ed.). Pearson.
Turing, A. M. (1936). On Computable Numbers, with an Application to the Entscheidungsproblem. Proceedings of the London Mathematical Society, 2(42), 230–265.
Turing, A. M. (1950). Computing Machinery and Intelligence. Mind, 59(236), 433–460.
McCorduck, P. (2004). Machines Who Think: A Personal Inquiry into the History and Prospects of Artificial Intelligence (2nd ed.). A K Peters.
Nilsson, N. J. (2010). The Quest for Artificial Intelligence: A History of Ideas and Achievements. Cambridge University Press.
al-Jazarī, I. (1974). The Book of Knowledge of Ingenious Mechanical Devices (D. R. Hill, Trans.). D. Reidel Publishing Company.
Hill, D. R. (1998). Mechanical Engineering in the Medieval Near East. Scientific American, 264(5), 100–105.
Hill, D. R. (1991). Islamic Science and Engineering. Edinburgh University Press.
Encyclopaedia Britannica. al-Jazari.
Ceccarelli, M. (2004). Distinguished Figures in Mechanism and Machine Science. Springer.
Geschichte der Künstlichen Intelligenz
Rebaz Ahmed
Autorin / Autor