सोचने और निर्णय लेने में सक्षम मशीन बनाने का विचार आधुनिक कंप्यूटरों के आगमन से शुरू नहीं हुआ; इसकी जड़ें हज़ारों साल पुरानी हैं। पूरे मानव इतिहास में, कई दार्शनिकों, विचारकों और वैज्ञानिकों ने इन प्रश्नों को समझने का प्रयास किया है: "बुद्धिमत्ता का मूल स्वभाव क्या है?" और "क्या बुद्धिमत्ता का कृत्रिम रूप से निर्माण किया जा सकता है?"। ये सैद्धांतिक प्रश्न उन विचारों की नींव बने जिनके कारण अंततः कृत्रिम बुद्धिमत्ता (AI) का एक स्वतंत्र ज्ञानशाखा के रूप में उदय हुआ।
प्राचीन यूनान में, प्लेटो (Plato) और अरस्तू (Aristotle) जैसे दार्शनिकों ने तर्कशास्त्र, व्यवस्थित सोच और ज्ञान प्राप्त करने की विधियों पर बहुत ज़ोर दिया। अरस्तू ने विशेष रूप से औपचारिक तर्क (Formal Logic) की पहली प्रणाली विकसित की, जिसमें उन्होंने निगमनात्मक तर्क (Syllogism) के नियमों को निर्धारित किया। यद्यपि इन शुरुआती कार्यों ने सीधे एआई का निर्माण नहीं किया, लेकिन उन्होंने इस मूलभूत सिद्धांत की नींव रखी कि मानव सोच को निर्धारित नियमों और सिद्धांतों के माध्यम से प्रतीकात्मक रूप से वर्णित किया जा सकता है।
मध्य काल और आधुनिक युग की शुरुआत में, गणितज्ञों और दार्शनिकों ने तर्कशास्त्र और गणित के एकीकरण को व्यवस्थित रूप से विकसित करने का प्रयास किया। 17वीं शताब्दी में, गॉटफ्रीड विल्हेम लीबनिज (Gottfried Wilhelm Leibniz) ने तर्क और अवधारणाओं की अभिव्यक्ति के लिए एक सार्वभौमिक प्रतीकात्मक भाषा का प्रस्ताव रखा। उनका मानना था कि यदि सभी विचारों को गणितीय नियमों में परिवर्तित किया जा सके, तो भविष्य के गणना उपकरण गणितीय रूप से जटिल समस्याओं को हल करने में सक्षम होंगे। यद्यपि यह विचार उस समय व्यावहारिक नहीं था, लेकिन इसने एआई के लिए एक महत्वपूर्ण बुद्धिवादी आधार प्रदान किया।
19वीं शताब्दी में, कंप्यूटिंग और स्वचालन (Automation Engineering) में महत्वपूर्ण तकनीकी प्रगति हुई। चार्ल्स बैबेज (Charles Babbage) ने "एनालिटिकल इंजन" (Analytical Engine) डिज़ाइन किया, जिसमें आधुनिक कंप्यूटरों की कई मुख्य विशेषताएं शामिल थीं; जैसे मेमोरी (Memory), एक प्रोसेसिंग यूनिट (ALU) और प्रोग्रामिंग क्षमता। यद्यपि यह मशीन कभी पूरी तरह से निर्मित नहीं हो सकी, लेकिन विज्ञान के इतिहासकार इसे पहले सामान्य-उद्देश्यीय कंप्यूटर के डिज़ाइन के रूप में स्वीकार करते हैं।
इसी युग के दौरान, एडा लवलेस (Ada Lovelace)—जिन्हें दुनिया की पहली कंप्यूटर प्रोग्रामर माना जाता है—ने एक अत्यंत दूरदर्शी अवलोकन किया। उन्होंने भविष्यवाणी की कि भविष्य के गणना उपकरण न केवल केवल संख्याओं की गणना करेंगे, बल्कि वे संगीत, छवियों और विभिन्न प्रकार के गैर-संरचित डेटा को भी प्रोसेस करने में सक्षम होंगे। यह विचार उस समय के लिए अत्यंत क्रांतिकारी था और बाद में एआई के क्षितिज को व्यापक बनाने में बहुत महत्वपूर्ण साबित हुआ।
20वीं शताब्दी की शुरुआत में, औपचारिक तर्क और गणितीय नींव का विकास तेजी से बढ़ा। जॉर्ज बूले (George Boole) का बूलियन बीजगणित पर काम, और उसके बाद गोटलोब फ्रेगे (Gottlob Frege), बर्ट्रेंड रसेल (Bertrand Russell) और अल्फ्रेड नॉर्थ व्हाइटहेड (Alfred North Whitehead) के शोध ने गणितीय तर्क के लिए एक ठोस संरचना तैयार की। इन गणितीय योगदानों ने यह सिद्ध किया कि मानव सोच के कुछ पैटर्न को औपचारिक नियमों द्वारा व्यक्त किया जा सकता है और एक स्वचालित मशीन द्वारा निष्पादित किया जा सकता है।
इस चरण में सबसे बड़ा प्रतिमान विस्थापन (Paradigm Shift) एलन ट्यूरिंग (Alan Turing) के मौलिक योगदान से आया। 1936 में, अपने ऐतिहासिक पत्र On Computable Numbers, with an Application to the Entscheidungsproblem में, ट्यूरिंग ने "ट्यूरिंग मशीन" (Turing Machine) का सैद्धांतिक मॉडल पेश किया। उन्होंने यह गणितीय रूप से सिद्ध किया कि कोई भी तार्किक प्रक्रिया, यदि उसे एल्गोरिदम द्वारा सटीक रूप से परिभाषित किया जा सके, तो उसे एक सार्वभौमिक ट्यूरिंग मशीन द्वारा निष्पादित किया जा सकता है। यह सैद्धांतिक अवधारणा कंप्यूटर विज्ञान और एआई का मूल आधार बनी।
द्वितीय विश्व युद्ध के बाद, इलेक्ट्रॉनिक कंप्यूटरों के आगमन ने इन सिद्धांतों को व्यावहारिक रूप से लागू करने का एक नया अवसर प्रदान किया। 1950 में, ट्यूरिंग ने Mind पत्रिका में Computing Machinery and Intelligence शीर्षक से एक मील का पत्थर पत्र प्रकाशित किया और ऐतिहासिक प्रश्न पूछा: "क्या मशीनें सोच सकती हैं?" ("Can machines think?")। इसके साथ ही, उन्होंने कंप्यूटर प्रणाली के मानव-तुल्य व्यवहार का मूल्यांकन करने के लिए एक व्यावहारिक परीक्षण का प्रस्ताव रखा—जिसे बाद में "ट्यूरिंग टेस्ट" (Turing Test) के रूप में जाना गया।
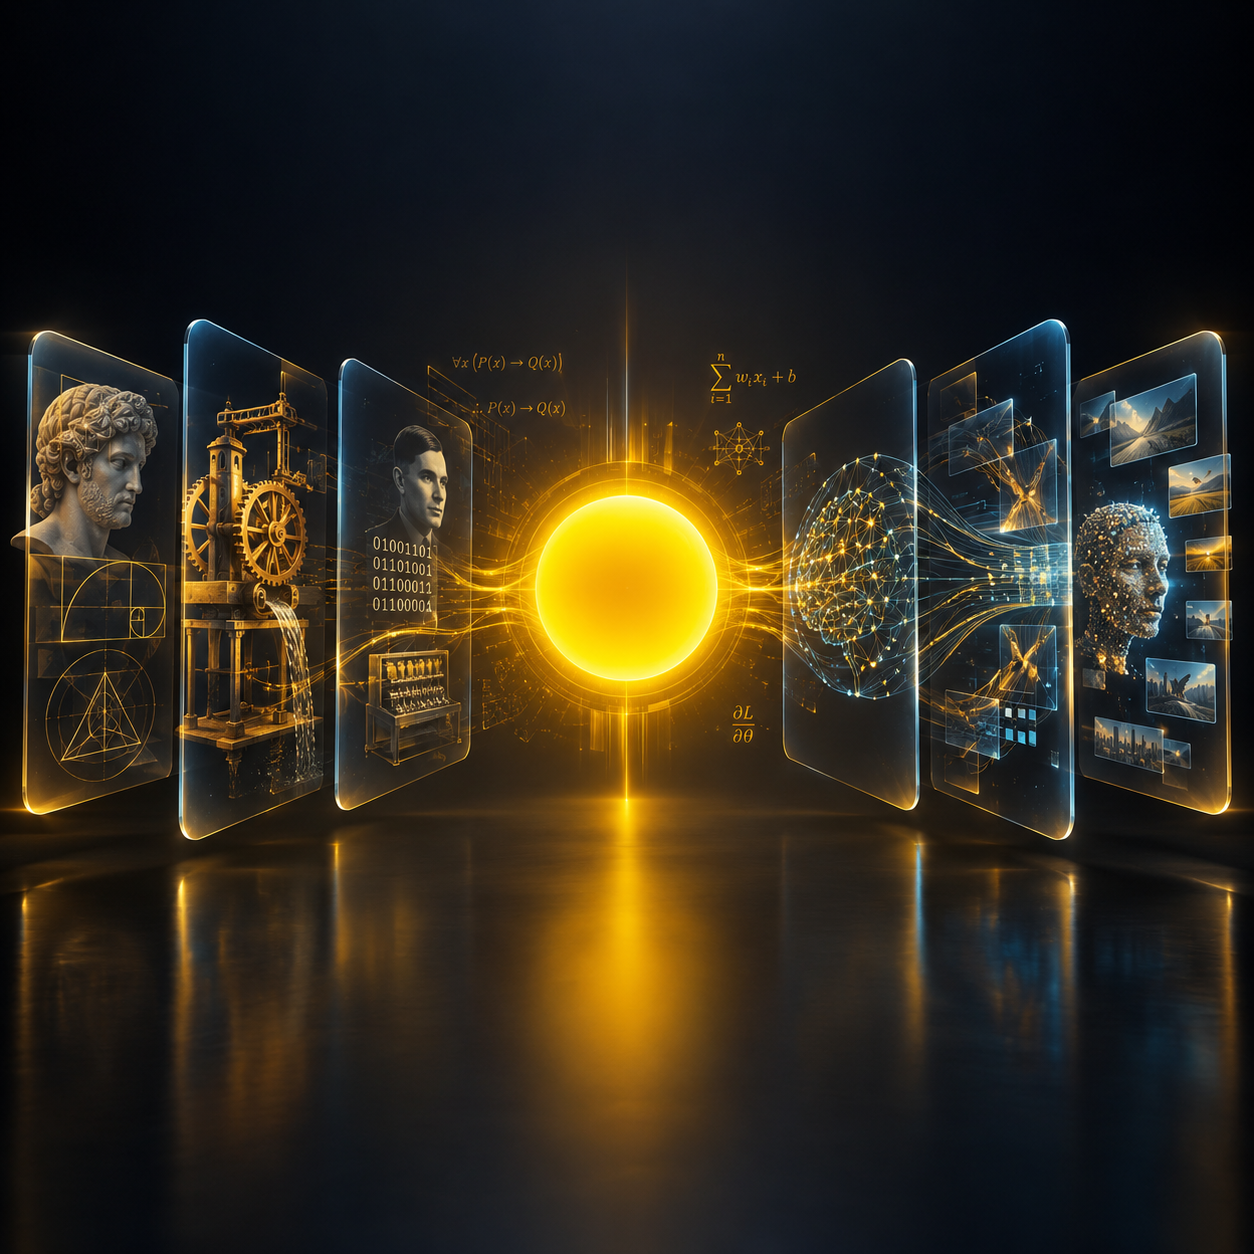
इन सभी प्रगतियों—प्राचीन ग्रीक तर्कशास्त्र, लीबनिज के गणितीय दर्शन, बैबेज के एनालिटिकल इंजन, लवलेस की कंप्यूटेशनल दृष्टि और ट्यूरिंग के गणना सिद्धांत—ने एआई के जन्म के लिए ठोस वैज्ञानिक और बौद्धिक आधार प्रदान किया। अंततः, यह कार्य 1956 में डार्टमाउथ सम्मेलन (Dartmouth Conference) में समाप्त हुआ, जहाँ कृत्रिम बुद्धिमत्ता को आधिकारिक तौर पर एक स्वतंत्र वैज्ञानिक विषय के रूप में स्थापित किया गया।
इस्माइल अल-जज़ारी और प्रारंभिक ऑटोमेटा इंजीनियरिंग (Al-Jazari and Automata)
एआई के आधिकारिक जन्म से सदियों पहले, स्वचालित उपकरणों और स्व-संचालित प्रणालियों को बनाने के प्रयासों ने रोबोटिक्स और मैकेनिकल इंजीनियरिंग के लिए एक गहरा व्यावहारिक आधार तैयार किया। इस क्षेत्र के सबसे प्रमुख अग्रदूतों में से एक बदी अल-ज़मान अबुल-इज़ इस्माइल इब्न अल-रज़ाज़ अल-जज़ारी (Ismail al-Jazari, 1136–1206 ईस्वी) थे। अल-जज़ारी उत्तरी कुर्दिस्तान के आमेद (वर्तमान दियारबकिर) शहर में फले-फूले और लगभग पचास वर्षों तक अर्तुकिद (Artuqid) शासकों के दरबार में मुख्य इंजीनियर के रूप में कार्य किया।
1206 ईस्वी में, अल-जज़ारी ने अपनी प्रसिद्ध इंजीनियरिंग पांडुलिपि The Book of Knowledge of Ingenious Mechanical Devices पूरी की। यह कार्य मैकेनिकल इंजीनियरिंग के इतिहास में सबसे महत्वपूर्ण ऐतिहासिक ग्रंथों में से एक माना जाता है, जिसमें सटीक व्याख्याओं और चित्रों के साथ लगभग 50 स्वचालित यांत्रिक उपकरणों का विवरण दिया गया है। उनके आविष्कारों में जटिल जल घड़ियाँ, डबल-एक्टिंग हाइड्रोलिक पंप (Double-acting Pump), स्वचालित सेवक, स्वचालित हाथ धोने के तंत्र और स्वचालित संगीत बैंड शामिल थे—जो पूरी तरह से द्रव गतिशास्त्र, गुरुत्वाकर्षण और कैम तंत्र (Cam Mechanism) के माध्यम से बिना किसी मानवीय हस्तक्षेप के स्वचालित रूप से काम करते थे।
प्रौद्योगिकी के कई इतिहासकार अल-जज़ारी को "मैकेनिकल इंजीनियरिंग और ऑटोमेशन कंट्रोल थ्योरी के संस्थापकों" में से एक मानते हैं। यद्यपि उनकी मशीनों में आधुनिक अर्थ में कृत्रिम बुद्धिमत्ता नहीं थी—उनमें सीखने, निर्णय लेने या स्वतंत्र रूप से व्यवहार करने की क्षमता नहीं थी—फिर भी उनका रचनात्मक कार्य मानव-रूपी ऑटोमेटा और स्व-संचालित मशीनों के निर्माण के इतिहास में एक अत्यंत महत्वपूर्ण मील का पत्थर है।
एलन ट्यूरिंग और ट्यूरिंग टेस्ट (Alan Turing and the Turing Test)
एलन मैथिसन ट्यूरिंग (1912–1954) को कंप्यूटर विज्ञान और कृत्रिम बुद्धिमत्ता का एक बुनियादी संस्थापक माना जाता है। उनके शोध ने न केवल कंप्यूटिंग के लिए सैद्धांतिक ढांचा प्रदान किया, बल्कि मशीनों की मानव बुद्धिमत्ता की नकल करने की क्षमता का मूल्यांकन करने के तरीके में भी एक नया प्रतिमान स्थापित किया। इसके अतिरिक्त, ट्यूरिंग ने द्वितीय विश्व युद्ध के दौरान जर्मन 'एनिग्मा' (Enigma) कोड को तोड़ने में महत्वपूर्ण भूमिका निभाई, जिसने मित्र राष्ट्रों की जीत और आधुनिक कंप्यूटरों के विकास को गहराई से प्रभावित किया।
ट्यूरिंग मशीन मॉडल और कंप्यूटेशनल विज्ञान की नींव
1936 में, ट्यूरिंग ने अपना ऐतिहासिक पत्र On Computable Numbers, with an Application to the Entscheidungsproblem प्रकाशित किया, जिसमें "ट्यूरिंग मशीन" नामक सैद्धांतिक गणितीय मॉडल पेश किया गया।
यह एक भौतिक उपकरण नहीं था, बल्कि एक गणितीय संरचना थी जो यह दर्शाती थी कि कैसे किसी भी तार्किक प्रक्रिया को चरण-दर-चरण निर्देशों के माध्यम से निष्पादित किया जा सकता है। इसका महत्व एल्गोरिदम द्वारा वर्णित किसी भी समस्या की समाधान क्षमता को सिद्ध करने में था: यानी कोई भी समस्या जो एल्गोरिदम द्वारा व्यक्त की जा सकती है, उसे सिद्धांत रूप में एक सार्वभौमिक ट्यूरिंग मशीन द्वारा हल किया जा सकता है। यह विचार आधुनिक कंप्यूटर विज्ञान का आधार बना।
"क्या मशीनें सोच सकती हैं?"
1950 में, ट्यूरिंग ने Mind पत्रिका में Computing Machinery and Intelligence शीर्षक से एक पत्र प्रकाशित किया और प्रश्न पूछा:
"Can machines think?" ("क्या मशीनें सोच सकती हैं?")
ट्यूरिंग का तर्क था कि "सोचना" शब्द दार्शनिक और अर्थशास्त्र की दृष्टि से बहुत अस्पष्ट है। इसलिए, उन्होंने इस अमूर्त प्रश्न के स्थान पर कंप्यूटर प्रणालियों के व्यवहारिक प्रदर्शन का मूल्यांकन करने के लिए एक व्यवहार्य परीक्षण का प्रस्ताव रखा।
ट्यूरिंग टेस्ट (The Turing Test)
मूल रूप से "इमिटेशन गेम" (Imitation Game) कहे जाने वाले इस परीक्षण में तीन मुख्य प्रतिभागी शामिल होते हैं:
एक मानव प्रतिभागी (मानदंड के रूप में);
एक कंप्यूटर या एआई प्रणाली (जो मानव व्यवहार का अनुकरण करने का प्रयास करती है);
एक अलग कमरे में बैठा एक मानव मूल्यसाधक (Judge) (जो अंध-परीक्षण स्थितियों के तहत निर्णय लेता है)।
मूल्यसाधक केवल टेक्स्ट संदेशों के माध्यम से दोनों से संवाद करता है। यदि अंत में मूल्यसाधक मशीन और मनुष्य के बीच अंतर करने में असमर्थ रहता है, तो मशीन को परीक्षण पास माना जाता है।
अकादमिक नोट: इस परीक्षण का उद्देश्य यह साबित करना नहीं है कि मशीन में "चेतना" या "भावनाएं" हैं, बल्कि केवल यह मापना है कि क्या उसका संवादात्मक व्यवहार मनुष्य के समान बुद्धिमत्ता का प्रदर्शन करता है।
एआई के विकास पर प्रभाव
ट्यूरिंग टेस्ट एआई के इतिहास में सबसे प्रभावशाली मानकों में से एक बन गया। इसने पहली बार बुद्धिमान प्रणालियों की क्षमता का मूल्यांकन करने के लिए एक व्यावहारिक ढांचा प्रदान किया। इस दृष्टिकोण ने 1950 के बाद के शोध को गहराई से प्रभावित किया और चैटबॉट्स, प्रश्न-उत्तर प्रणालियों और आधुनिक बड़े भाषा मॉडलों (LLMs) के विकास को प्रेरित किया।
21वीं सदी में बड़े भाषा मॉडलों के आगमन के साथ ट्यूरिंग टेस्ट पर चर्चा पुनः महत्वपूर्ण हो गई है। यद्यपि कुछ आधुनिक प्रणालियाँ संवादात्मक स्तर पर मानव जैसी क्षमता दिखाती हैं, लेकिन अकादमिक समुदाय इस बात पर सहमत है कि केवल ट्यूरिंग टेस्ट पास करना सामान्य कृत्रिम बुद्धिमत्ता (AGI) या चेतना की उपस्थिति का प्रमाण नहीं है, क्योंकि एक प्रणाली वास्तविक समझ के बिना भी पैटर्न मिलान द्वारा मानव-जैसा व्यवहार उत्पन्न कर सकती है।
आलोचनाएं और सीमाएं
अपनी ऐतिहासिक प्रासंगिकता के बावजूद, ट्यूरिंग टेस्ट की आलोचना भी हुई है। दार्शनिक जॉन सार्ले (John Searle) ने अपने प्रसिद्ध "चाइनीज रूम" (Chinese Room) विचार प्रयोग द्वारा यह दिखाया कि एक प्रणाली वास्तविक अर्थ (Semantics) को समझे बिना केवल नियमों (Syntax) का पालन करके उत्तर उत्पन्न कर सकती है। इसके अलावा, संज्ञानात्मक विज्ञान यह मानता है कि मानव बुद्धिमत्ता केवल भाषा तक सीमित नहीं है, बल्कि यह परिवेश को समझने, निर्णय लेने और वास्तविक दुनिया के साथ बातचीत करने से गहराई से जुड़ी है।
डार्टमाउथ सम्मेलन और कृत्रिम बुद्धिमत्ता का आधिकारिक जन्म (The Dartmouth Conference and the Formal Birth of AI)
अधिकांश कंप्यूटर इतिहासकारों और अकादमिक समुदाय द्वारा 1956 को कृत्रिम बुद्धिमत्ता (Artificial Intelligence, AI) के एक स्वतंत्र वैज्ञानिक विषय के रूप में आधिकारिक जन्म का वर्ष माना जाता है। इस वर्ष की ग्रीष्मऋतु में, अमरीका के न्यू हैम्पशायर राज्य स्थित डार्टमाउथ कॉलेज (Dartmouth College) में एक ऐतिहासिक शोध संगोष्ठी का आयोजन किया गया, जिसे "डार्टमाउथ समर रिसर्च प्रोजेक्ट ऑन आर्टिफ़िशियाली इंटेलिजेंस" के नाम से जाना जाता है।
यह सम्मेलन एक स्वतंत्र वैज्ञानिक क्षेत्र का निर्माण करने का पहला व्यवस्थित प्रयास था, जो पूरी तरह से इस बात के अध्ययन के लिए समर्पित था कि बुद्धिमत्तापूर्ण व्यवहार प्रदर्शित करने वाली प्रणालियों का निर्माण कैसे किया जाए।
परियोजना की उत्पत्ति और अग्रदूत (Origins and Pioneers)
इस सम्मेलन का विचार सबसे पहले जॉन मैकार्थी (John McCarthy) द्वारा प्रस्तावित किया गया था, जिन्हें बाद में "कृत्रिम बुद्धिमत्ता का जनक" माना गया। उनके साथ इस प्रस्ताव को तैयार करने वाले अन्य अग्रदूतों में मार्विन मिंस्की (Marvin Minsky), आईबीएम (IBM) के नथानिएल रोचेस्टर (Nathaniel Rochester), और सूचना सिद्धांत (Information Theory) के संस्थापक क्लाउड शैनन (Claude Shannon) शामिल थे।
प्रस्ताव के मूल पाठ में निम्नलिखित मुख्य अकादमिक परिकल्पना शामिल थी:
"सीखने के प्रत्येक पहलू या बुद्धिमत्ता की किसी भी अन्य विशेषता का इतने सटीक रूप से वर्णन किया जा सकता है कि एक मशीन उसकी सटीक नकल कर सके।"
यह कथन उस समय के शोधकर्ताओं के लिए एक ठोस बौद्धिक आधार बन गया; क्योंकि वे पूरी तरह से मानते थे कि मानव बुद्धिमत्ता को नियमों, एल्गोरिदम और कम्प्यूटेशनल शक्ति के माध्यम से परिभाषित किया जा सकता है और फिर उसे कंप्यूटर द्वारा निष्पादित किया जा सकता है।
"Artificial Intelligence" शब्दावली का उद्भव (Birth of the Term "Artificial Intelligence")
डार्टमाउथ सम्मेलन का सबसे महत्वपूर्ण और ऐतिहासिक परिणाम यह था कि जॉन मैकार्थी ने पहली बार आधिकारिक तौर पर "Artificial Intelligence" (कृत्रिम बुद्धिमत्ता) शब्दावली का प्रयोग किया। उससे पहले, इस क्षेत्र के शोध को साइबरनेटिक्स (Cybernetics), ऑटोमेटा थ्योरी (Automata Theory), या कॉम्प्लेक्स इंफॉर्मेशन प्रोसेसिंग (Complex Information Processing) जैसे विभिन्न नामों से जाना जाता था।
इस नए नाम के चयन के पीछे एक रणनीतिक कारण था: मैकार्थी इस क्षेत्र को अन्य विज्ञानों से अलग करना चाहते थे और इसके लिए एक स्वतंत्र पहचान स्थापित करना चाहते थे। इस दृष्टि से, 1956 केवल एक सम्मेलन के आयोजन का वर्ष नहीं था, बल्कि एक नए वैज्ञानिक अनुशासन का आधिकारिक जन्म वर्ष था।
सम्मेलन के मुख्य उद्देश्य (Primary Objectives of the Conference)
डार्टमाउथ में भाग लेने वाले शोधकर्ताओं ने अत्यंत आशावाद के साथ भविष्यवाणी की थी कि वे कुछ ही वर्षों में मानव बुद्धिमत्ता की मुख्य समस्याओं को हल कर लेंगे। उनके मुख्य उद्देश्यों में शामिल थे:
स्वचालित मशीन लर्निंग (Machine Learning) प्रणालियों का आविष्कार;
प्राकृतिक भाषा प्रसंस्करण (Natural Language Processing, NLP);
समस्या-समाधान और निर्णय लेने के तंत्र का औपचारिकीकरण;
तार्किक सोच का औपचारिक विश्लेषण;
छवियों और वस्तुओं को पहचानने की क्षमता का विकास;
एक ऐसी मशीन का निर्माण जो पूरी तरह से मानव-तुल्य व्यवहार प्रदर्शित कर सके।
यद्यपि उस समय शोधकर्ताओं का मानना था कि ये लक्ष्य निकट भविष्य में हासिल कर लिए जाएंगे, लेकिन बाद के घटनाक्रमों ने साबित किया कि मानव बुद्धिमत्ता शुरुआती विचारों की तुलना में कहीं अधिक जटिल और गहरी है।
अकादमिक प्रभाव और संस्थागत समर्थन (Academic Impact and Institutional Support)
यद्यपि डार्टमाउथ सम्मेलन से स्वयं सीधे तौर पर कोई बड़ी तकनीकी सफलता नहीं मिली, लेकिन कंप्यूटर विज्ञान की दिशा तय करने में इसका प्रभाव अभूतपूर्व था। इस आयोजन के बाद, दुनिया के अग्रणी विश्वविद्यालयों ने एआई प्रयोगशालाएं स्थापित करना शुरू कर दिया, जिनमें मैसाचुसेट्स इंस्टीट्यूट ऑफ टेक्नोलॉजी (MIT), स्टैनफोर्ड यूनिवर्सिटी (Stanford University), और कार्नेगी मेलन यूनिवर्सिटी (Carnegie Mellon University) शामिल हैं।
इसके साथ ही, अमरीकी सरकार और DARPA जैसी संस्थाओं ने इस नए क्षेत्र के लिए भारी वित्तीय सहायता प्रदान की। यह वित्तीय सहायता पहले बुद्धिमान कार्यक्रमों को विकसित करने और मशीन लर्निंग के विज्ञान को आगे बढ़ाने के लिए मुख्य चालक बनी।
प्रारंभिक और अग्रणी उपलब्धियां: 1950–1960 का दशक (Early Breakthroughs: 1950s–1960s)
1950 के दशक के उत्तरार्ध और 1960 के दशक की शुरुआत में, कई ऐतिहासिक परियोजनाएं सामने आईं, जिनमें सबसे महत्वपूर्ण थीं:
लॉजिक थ्योरिस्ट (Logic Theorist, 1956): एलन नेवेल (Allen Newell) और हर्बर्ट साइमन (Herbert A. Simon) द्वारा विकसित किया गया, जिसे इतिहास में पहला एआई कार्यक्रम माना जाता है और इसमें कुछ प्रतीकात्मक तर्क पहेलियों को हल करने की क्षमता थी।
जनरल प्रॉब्लम सॉल्वर (General Problem Solver, GPS): तार्किक समस्याओं को हल करने के उद्देश्य से एक सार्वभौमिक प्रणाली बनाने का एक अग्रणी प्रयास।
LISP प्रोग्रामिंग भाषा (1958): स्वयं जॉन मैकार्थी द्वारा आविष्कृत, जो कई दशकों तक दुनिया भर में एआई शोध के लिए प्राथमिक भाषा के रूप में उपयोग की जाती रही।
इन उपलब्धियों ने, अपनी सीमाओं के बावजूद, यह साबित कर दिया कि कंप्यूटर तार्किक सोच के कार्यों को सफलतापूर्वक निष्पादित कर सकते हैं।
एआई विंटर्स (AI Winters)
1950 के दशक के अंत और 1960 के दशक की शुरुआत में एआई की मजबूत शुरुआत के बाद, कई शोधकर्ता और निवेशक आशावादी थे कि कुछ ही वर्षों में कंप्यूटर अधिकांश मानवीय बुद्धिमान कार्यों को संभालने में सक्षम होंगे। लेकिन ये उम्मीदें उस समय की तकनीक की वास्तविक क्षमताओं से मेल नहीं खाती थीं।
इस बड़े अंतर का परिणाम यह हुआ कि वित्तीय सहायता, सार्वजनिक विश्वास और शोध गतिविधियों में बार-बार भारी गिरावट आई। प्रौद्योगिकी के इतिहास में इन सुस्त चरणों को "एआई विंटर्स" (AI Winters) के रूप में जाना जाता है।
"एआई विंटर" शब्द उस ऐतिहासिक चक्र को संदर्भित करता है जिसमें इस क्षेत्र के लिए वित्तीय सहायता और सार्वजनिक उम्मीदें दोनों अत्यधिक गिर गईं; ऐसा इसलिए हुआ क्योंकि व्यावहारिक उपलब्धियां उन बड़ी भविष्यवाणियों के स्तर तक नहीं पहुंचीं जो शोधकर्ताओं और कंपनियों ने की थीं। ये विंटर्स एआई के इतिहास में सबसे महत्वपूर्ण मोड़ों में से थे, क्योंकि उन्होंने इस क्षेत्र को अपने दृष्टिकोण और सिद्धांतों का पुनर्मूल्यांकन करने के लिए मजबूर किया।
पहला एआई विंटर: 1970 का दशक (The First AI Winter: 1970s)
इस क्षेत्र का पहला एआई विंटर 1960 के दशक के अंत और 1970 के दशक की शुरुआत में शुरू हुआ। उस युग में, यद्यपि Logic Theorist, GPS और ELIZA जैसे शुरुआती बुद्धिमान कार्यक्रमों ने मीडिया और वैज्ञानिक समुदायों का ध्यान आकर्षित किया था, लेकिन उनकी क्षमताएं अत्यधिक सीमित थीं। इनमें से अधिकांश प्रणालियाँ केवल एक नियंत्रित प्रयोगशाला वातावरण में काम करती थीं और वास्तविक दुनिया की जटिल समस्याओं का सामना करने में विफल रहती थीं।
Perceptrons पुस्तक (1969): इस वर्ष, मार्विन मिंस्की (Marvin Minsky) और सेय्मूर पैपर्ट (Seymour Papert) ने अपनी प्रसिद्ध पुस्तक Perceptrons प्रकाशित की, जिसमें उन्होंने एकल-स्तरीय कृत्रिम न्यूरल नेटवर्क की गणितीय सीमाओं को स्पष्ट किया। यद्यपि उनकी आलोचना वैज्ञानिक रूप से पूरी तरह से सही थी, लेकिन कई वित्तीय समर्थकों ने इसका यह अर्थ निकाला कि न्यूरल नेटवर्क का कोई भविष्य नहीं है; इसके कारण लगभग दो दशकों के लिए इस क्षेत्र में शोध रुक गया।
लाइटहिल रिपोर्ट (1973): इस वर्ष, ब्रिटिश सरकार ने Lighthill Report नाम से एक रणनीतिक रिपोर्ट प्रकाशित की। यह रिपोर्ट गणितज्ञ सर जेम्स लाइटहिल (Sir James Lighthill) द्वारा तैयार की गई थी, जिसमें उन्होंने एआई की सीमाओं और व्यावहारिक उपलब्धियों की कमी की तीखी आलोचना की थी। इस रिपोर्ट के प्रकाशन के बाद, ब्रिटेन में इस क्षेत्र की अधिकांश परियोजनाओं की वित्तीय सहायता रोक दी गई, जिसने अंतर्राष्ट्रीय स्तर पर भी गहरा नकारात्मक प्रभाव छोड़ा।
नई आशाओं की वापसी: 1980 का दशक (The Revival of Hope: 1980s)
1980 के दशक में, एआई ने कंपनियों और सरकारों का ध्यान फिर से आकर्षित किया, विशेष रूप से एक्सपर्ट सिस्टम्स (Expert Systems) की व्यावसायिक सफलता के कारण। ये प्रणालियाँ किसी विशिष्ट क्षेत्र में विशेषज्ञों के ज्ञान और अनुभव को एकत्र करती थीं और निर्णय लेने व समस्याओं का विश्लेषण करने के लिए उनका उपयोग करती थीं। डिजिटल इक्विपमेंट कॉर्पोरेशन (DEC) और आईबीएम (IBM) जैसी दिग्गज कंपनियों ने इस क्षेत्र में भारी पूंजी लगाई।
उसी समय, जापान सरकार ने "पांचवीं पीढ़ी के कंप्यूटर सिस्टम" (Fifth Generation Computer Systems, FGCS) नाम से अपना महान राष्ट्रीय प्रोजेक्ट शुरू किया, जिसका उद्देश्य अत्यधिक जटिल समस्याओं को हल करने के लिए अत्यंत बुद्धिमान कंप्यूटर बनाना था। इन कदमों ने एआई के भविष्य के लिए एक नई उम्मीद जगाई।
दूसरा एआई विंटर: 1980 के दशक का अंत और 1990 के दशक की शुरुआत (The Second AI Winter: Late 1980s–Early 1990s)
1980 के दशक की शुरुआत के अत्यधिक आशावाद के बावजूद, दशक के अंत में कृत्रिम बुद्धिमत्ता एक बार फिर तकनीकी और इंजीनियरिंग की कठिन बाधाओं से टकराई। व्यावहारिक रूप से यह सिद्ध हुआ कि एक्सपर्ट सिस्टम्स (Expert Systems) के निर्माण और रखरखाव की लागत अत्यधिक उच्च थी, उनके ज्ञान-कोष (Knowledge Base) को अद्यतन करना अत्यंत जटिल था, और गतिशील व परिवर्तनशील वातावरण में उनकी अनुकूलन क्षमता (Adaptability) बेहद सीमित थी।
इसी समय, व्यक्तिगत कंप्यूटरों (Personal Computers, PCs) के बाजार में अभूतपूर्व वृद्धि हुई। कई संस्थाओं और कंपनियों ने कम खर्चीले सामान्य हार्डवेयर और सॉफ्टवेयर समाधानों को अपनाना शुरू कर दिया, जिन्हें महंगे और विशेष एआई-हार्डवेयर की आवश्यकता नहीं थी। परिणामस्वरूप, इस क्षेत्र की कई व्यावसायिक कंपनियाँ विफल हो गईं और शोध के लिए वित्तीय सहायता एक बार फिर घट गई। प्रौद्योगिकी के इतिहास में इस चरण को "दूसरे एआई विंटर" के रूप में दर्ज किया गया।
एआई विंटर्स के उदय के मुख्य कारण (Key Causes of AI Winters)
कई मौलिक और संरचनात्मक कारण एक के बाद एक इन सुस्त अवधियों के निर्माण का आधार बने:
अवास्तविक अपेक्षाएं और अति-आशावाद: अति-शीघ्रता से मानव-स्तरीय सामान्य बुद्धिमत्ता (AGI) प्राप्त करने की अवास्तविक भविष्यवाणियां।
कम्प्यूटेशनल क्षमता की सीमाएं: उस युग के कंप्यूटरों की प्रसंस्करण गति और मेमोरी क्षमता जटिल认知 कार्यों की तुलना में अत्यधिक सीमित थी।
पर्याप्त डेटा का अभाव: प्रणालियों को प्रशिक्षित करने के लिए आवश्यक परिमाण और उच्च गुणवत्ता वाले डेटासेट का उपलब्ध न होना।
शुरुआती एल्गोरिदम की सैद्धांतिक सीमाएं: आधुनिक मॉडल जैसी उच्च-स्तरीय विशेषताओं को स्वचालित रूप से निकालने वाले उन्नत एल्गोरिदम का अभाव।
प्रयोगशाला और वास्तविकता के बीच का अंतर: नियंत्रित प्रयोगशाला वातावरण में प्रणाली के प्रदर्शन और वास्तविक दुनिया की अनिश्चितताओं के बीच गहरा अंतर।
निवेशकों का मोहभंग: बड़े वादों के पूरा न होने पर सरकारों और कॉर्पोरेट जगत द्वारा अनुसंधान बजट में भारी कटौती।
मशीन लर्निंग का उदय (The Rise of Machine Learning)
एआई विंटर्स के अनुभवों से शोधकर्ताओं को यह स्पष्ट अहसास हुआ कि शुरुआती दौर की शास्त्रीय दृष्टिकोण—जो मुख्य रूप से मानव-लिखित नियम-आधारित प्रणालियों (Rule-Based Systems) पर निर्भर थी—की अपनी गंभीर सैद्धांतिक सीमाएं हैं। वास्तविक दुनिया की अधिकांश जटिल समस्याओं में, मानव द्वारा सभी सम्भावित नियमों और निर्णयों को कोडबद्ध करना व्यावहारिक रूप से असंभव था; क्योंकि वातावरण, परिस्थितियां और डेटा धाराएं निरंतर परिवर्तनशील थीं।
इस परिप्रेक्ष्य में, अनुसंधान में एक क्रांतिकारी प्रतिमान विस्थापन हुआ जिसे मशीन लर्निंग (Machine Learning, ML) के रूप में जाना गया। इस नए दृष्टिकोण में, कंप्यूटरों को अब पूर्व-निर्धारित स्पष्ट निर्देशों का इंतजार नहीं करना पड़ता था, बल्कि वे डेटा से सीधे पैटर्न और छिपे हुए संबंधों को सीखकर स्वचालित रूप से कार्यों को निष्पादित करने में सक्षम हुए।
हार्डवेयर की प्रगति और कम्प्यूटेशनल क्षमता में उछाल (Hardware Advances and Computational Growth)
मशीन लर्निंग का विकास केवल नए एल्गोरिदम के आविष्कार पर निर्भर नहीं था, बल्कि कंप्यूटर हार्डवेयर की तकनीकी प्रगति ने इसके लिए मुख्य उत्प्रेरक की भूमिका निभाई। 1990 के दशक और 2000 के दशक की शुरुआत में, इंटेल (Intel) और एएमडी (AMD) जैसी दिग्गज कंपनियों द्वारा सेंट्रल प्रोसेसिंग यूनिट्स (CPUs) के विकास ने कंप्यूटरों की प्रसंस्करण गति और दक्षता को काफी बढ़ा दिया। इस कम्प्यूटेशनल उछाल ने अधिक जटिल गणितीय मॉडलों के परीक्षण और बड़े डेटासेट के विश्लेषण का मार्ग प्रशस्त किया।
मशीन लर्निंग की अवधारणा और परिभाषा (Concept and Definition of Machine Learning)
मशीन लर्निंग कृत्रिम बुद्धिमत्ता की एक मुख्य शाखा है, जिसका उद्देश्य ऐसी प्रणालियों और सॉफ्टवेयर का निर्माण करना है जो डेटा से स्वचालित रूप से सीख सकें, छिपे हुए पैटर्न और संबंधों की पहचान कर सकें, और सटीक भविष्यवाणियां या निर्णय ले सकें; बिना इसके कि प्रोग्रामर को हर एक परिस्थिति के लिए स्पष्ट कोड लिखना पड़े।
इस क्षेत्र की सबसे प्रसिद्ध और क्लासिक परिभाषाओं में से एक, एआई के अग्रदूत आर्थर सैमुअल (Arthur Samuel) द्वारा 1959 में दी गई थी:
"मशीन लर्निंग अध्ययन का वह क्षेत्र है जो कंप्यूटरों को स्पष्ट रूप से प्रोग्राम किए बिना सीखने की क्षमता प्रदान करता है।"
मशीन लर्निंग के तेजी से विकास के मुख्य कारक (Drivers of Machine Learning Adoption)
1980 के दशक के अंत और विशेष रूप से 1990 के दशक के दौरान, कई मूलभूत परिवर्तनों ने मशीन लर्निंग के प्रसार को प्रेरित किया:
डिजिटल सूचना का विस्फोट: पहले बड़े मानक डेटासेट (Datasets) का निर्माण।
हार्डवेयर की मजबूती: प्रसंस्करण गति में वृद्धि और डेटा भंडारण लागत में कमी।
मूल विज्ञान की प्रगति: गणितीय सांख्यिकी, संभाव्यता सिद्धांत (Probability Theory) और अनुकूलन सिद्धांतों (Optimization Theory) का कंप्यूटर विज्ञान में एकीकरण।
बाजार और उद्योग की मांग: पूर्वानुमान, डेटा वर्गीकरण, छवि और आवाज पहचान प्रणालियों के लिए कंपनियों की ओर से भारी व्यावसायिक मांग।
इन कारकों ने शोधकर्ताओं को हजारों पंक्तियों के कठोर नियम लिखने के बजाय ऐसे लचीले मॉडल बनाने के लिए प्रेरित किया जो डेटा के भीतर से उत्तर खोज सकें।
मशीन लर्निंग के मुख्य प्रकार (Major Paradigms of Machine Learning)
मशीन लर्निंग की तकनीकों को मुख्य रूप से तीन मूलभूत प्रकारों में विभाजित किया जाता है:
सुपरवाइज्ड लर्निंग (Supervised Learning): इस प्रतिमान में, मॉडल को ऐसे डेटा पर प्रशिक्षित किया जाता है जिसमें स्पष्ट लक्ष्य लेबल (Labels) शामिल होते हैं। इसका मुख्य उद्देश्य इनपुट और आउटपुट के बीच के मैपिंग फ़ंक्शन को सीखना है ताकि नए डेटा पर सटीक भविष्यवाणी की जा सके।
उदाहरण: रियल एस्टेट की कीमतों का पूर्वानुमान, ईमेल स्पैम फ़िल्टरिंग, और मेडिकल इमेजरी से रोगों का निदान।
अनसुपरवाइज्ड लर्निंग (Unsupervised Learning): इसमें मशीन को दिए गए डेटा में कोई पूर्व-निर्धारित लेबल या उत्तर शामिल नहीं होता है। एल्गोरिदम डेटा के भीतर छिपी हुई संरचनाओं, वितरणों और आंतरिक समूहों (Clusters) को स्वचालित रूप से खोजने का प्रयास करता है।
उदाहरण: व्यवहार के आधार पर ग्राहकों का वर्गीकरण (Customer Segmentation), विसंगति पहचान (Anomaly Detection), और उच्च-आयामी डेटा का आयाम घटाना (Dimensionality Reduction)।
रीइन्फोर्समेंट लर्निंग (Reinforcement Learning): इस तकनीक में, प्रणाली (जिसे एजेंट या Agent कहा जाता है) एक गतिशील वातावरण में试错 (Trial and Error) के माध्यम से सीखती है। सही कार्यों के लिए उसे पुरस्कार (Reward) मिलता है और गलतियों के लिए दंड (Penalty)। समय के साथ, एजेंट अधिकतम संचयी पुरस्कार प्राप्त करने के लिए सर्वोत्तम व्यवहार नीति का निर्माण करता है।
उदाहरण: जटिल गेमिंग निर्णय (जैसे शतरंज और गो), रोबोटिक्स, स्वायत्त वाहन (Self-Driving Cars), और नेटवर्क का स्वचालित प्रबंधन।
एल्गोरिदम का विकास और न्यूरल नेटवर्क का पुनरुत्थान (Algorithmic Evolution and Resurgence of Neural Networks)
1990 और 2000 के दशकों में कई उत्कृष्ट सांख्यिकीय एल्गोरिदम विकसित हुए जिन्होंने आधुनिक मशीन लर्निंग की नींव रखी; जिनमें डिसीजन ट्री (Decision Trees), रैंडम फॉरेस्ट (Random Forests), सपोर्ट वेक्टर मशीन (Support Vector Machines, SVM), नैव बायस (Naïve Bayes), और k-नियरेस्ट नेबर्स (k-Nearest Neighbors, k-NN) शामिल हैं। इन एल्गोरिदम ने अर्थशास्त्र, चिकित्सा और प्राकृतिक भाषा प्रसंस्करण के क्षेत्रों में महत्वपूर्ण व्यावहारिक सफलताएं प्राप्त कीं।
इसी समय, यद्यपि पहले एआई विंटर के बाद कृत्रिम न्यूरल नेटवर्क को नजरअंदाज कर दिया गया था, लेकिन 1980 और 1990 के दशकों में जेफ्री हिंटन (Geoffrey Hinton), डेविड रुमेलहार्ट (David Rumelhart) और रोनाल्ड विलियम्स जैसे वैज्ञानिकों द्वारा बैकप्रोपेगेशन एल्गोरिदम (Backpropagation) पर किए गए निरंतर अध्ययनों ने शोध समुदाय का ध्यान पुनः न्यूरल नेटवर्क की ओर आकर्षित किया। बैकप्रोपेगेशन ने बहुस्तरीय न्यूरल नेटवर्क को कुशलतापूर्वक प्रशिक्षित करने का एक गणितीय तरीका प्रदान किया, जो बाद में डीप लर्निंग (Deep Learning) क्रांति का मुख्य आधार बना।
"Big Data" की अवधारणा और GPU चिप्स का उदय (Big Data and GPU Acceleration)
21वीं सदी की शुरुआत में, इंटरनेट के प्रसार, सोशल मीडिया नेटवर्क, स्मार्टफोन और डिजिटल सेवाओं के विस्फोट के कारण दुनिया भर में उत्पन्न होने वाले डेटा की मात्रा में अभूतपूर्व वृद्धि हुई, जिसे बिग डेटा (Big Data) के रूप में जाना गया।
चूंकि मशीन लर्निंग मॉडल की सटीकता और क्षमता उच्च गुणवत्ता वाले व्यापक डेटा पर निर्भर करती है, इसलिए बिग डेटा का आगमन इस क्षेत्र की सफलता के लिए मुख्य ईंधन बना। इसके साथ ही, सेंट्रल प्रोसेसिंग यूनिट (CPU) से ग्राफिक्स प्रोसेसिंग यूनिट (GPU) की ओर स्थानांतरण और समांतर संगणना (Parallel Computing) की तकनीकों के विकास ने विशाल मॉडलों के प्रशिक्षण समय को महीनों से घटाकर केवल कुछ दिनों या घंटों में समेट दिया।
प्रौद्योगिकी के भविष्य पर मशीन लर्निंग का प्रभाव (Strategic Impact of ML)
मशीन लर्निंग के उद्भव ने एआई अनुसंधान के रोडमैप और दर्शन को पूरी तरह से बदल दिया। इस वैचारिक परिवर्तन ने उन कई तकनीकों की सफलता का मार्ग प्रशस्त किया जिनका उपयोग हम आज अपने दैनिक जीवन में करते हैं; जैसे:
अनुशंसा प्रणालियां (Recommendation Systems): जैसे Netflix और Spotify में उपयोगकर्ता की रुचि पर आधारित एल्गोरिदम।
वास्तविक समय भाषा अनुवाद: बहुभाषी प्राकृतिक भाषा प्रसंस्करण।
आवाज और छवि पहचान: कंप्यूटर विज़न और बायोमेट्रिक पहचान।
डिजिटल स्वास्थ्य और चिकित्सा: रोगों का शुरुआती चरण में सटीक निदान।
बिजनेस इंटेलिजेंस और साइबर सुरक्षा: स्वचालित जोखिम विश्लेषण और स्पैम फ़िल्टरिंग।
सबसे महत्वपूर्ण बात यह है कि मशीन लर्निंग ने एक ठोस पुल के रूप में कार्य किया जिसने डीप लर्निंग (Deep Learning) और जेनेरेटिव एआई (Generative AI) के उदय का मार्ग प्रशस्त किया, जो आज वैश्विक प्रौद्योगिकी के शिखर पर हैं।
डीप लर्निंग क्रांति: एआई का सबसे बड़ा प्रतिमान विस्थापन (The Deep Learning Revolution)
डीप लर्निंग (Deep Learning) को कृत्रिम बुद्धिमत्ता के इतिहास में सबसे महत्वपूर्ण और प्रभावशाली मोड़ों में से एक माना जाता है। यद्यपि कृत्रिम न्यूरल नेटवर्क (ANNs) के सैद्धांतिक सिद्धांत 1940 और 1950 के दशकों में ही स्थापित हो गए थे, लेकिन दशकों तक कम्प्यूटेशनल क्षमता की कमी, डेटा की अनुपलब्धता और गहरे नेटवर्क को प्रशिक्षित करने की गणितीय जटिलताओं ने इस क्षेत्र की प्रगति को रोके रखा।
21वीं सदी की शुरुआत में तीन मूलभूत कारकों का ऐतिहासिक मिलन हुआ—डिजिटल डेटा का अभूतपूर्व विस्फोट (Big Data), ग्राफिक्स चिप्स (GPUs) का कम्प्यूटेशनल विकास, और नए शिक्षण एल्गोरिदम का उद्भव। इन तीनों के संयोजन ने डीप लर्निंग को वैश्विक एआई प्रगति का प्राथमिक इंजन बना दिया।
हार्डवेयर दर्शन में बदलाव: CPU से GPU की ओर स्थानांतरण
डीप लर्निंग क्रांति की मुख्य कुंजियों में से एक मॉडलों की कम्प्यूटेशनल प्रक्रिया को सेंटवेल प्रोसेसिंग यूनिट (CPU) से ग्राफिक्स प्रोसेसिंग यूनिट (GPU) पर स्थानांतरित करना था। GPU चिप्स को मूल रूप से कंप्यूटर गेम और 3D ग्राफिक्स रेंडरिंग के लिए डिज़ाइन किया गया था, लेकिन शोधकर्ताओं ने पाया कि ये चिप्स एक ही समय में हजारों गणितीय मैट्रिक्स ऑपरेशन्स को समानांतर (Parallel) रूप से निष्पादित कर सकते हैं—और यही विशेषता गहरे न्यूरल नेटवर्क के प्रशिक्षण के लिए आवश्यक थी।
NVIDIA कंपनी ने 2006 में अपने प्रसिद्ध CUDA प्लेटफॉर्म को लॉन्च करके एक बड़ी क्रांति ला दी। इस प्लेटफॉर्म ने शोधकर्ताओं को वैज्ञानिक संगणना और एआई मॉडलों के लिए GPU की कम्प्यूटेशनल शक्ति का सीधे उपयोग करने की अनुमति दी। इस तकनीकी परिवर्तन ने 2012 में AlexNet मॉडल की ऐतिहासिक सफलता और डीप लर्निंग क्रांति की आधिकारिक शुरुआत का आधार रखा।
डीप लर्निंग के सिद्धांत और संरचना (Principles and Architecture of Deep Learning)
डीप लर्निंग मशीन लर्निंग की एक उन्नत शाखा है जो गहरे न्यूरल नेटवर्क (Deep Neural Networks, DNNs) पर आधारित है। इन नेटवर्क में कई आंतरिक परतें (Hidden Layers) शामिल होती हैं, जहाँ प्रत्येक परत डेटा से अमूर्त विशेषताओं का एक नया स्तर सीखती है।
उदाहरण के लिए, कंप्यूटर विज़न छवि पहचान प्रणाली में:
प्रारंभिक परतें: केवल किनारों, रेखाओं और प्राथमिक आकृतियों की पहचान करती हैं।
मध्यम परतें: जटिल आकृतियों और बनावट को जोड़ती हैं।
उच्चतम परतें: संपूर्ण वस्तुओं (जैसे मानव चेहरे या वाहनों) का प्रतिनिधित्व करती हैं।
शास्त्रीय मशीन लर्निंग और डीप लर्निंग के बीच मौलिक अंतर यह है:
शास्त्रीय दृष्टिकोण: इसमें मानव विशेषज्ञों द्वारा डेटा की विशेषताओं (Features) को मैन्युअल रूप से निष्पादित और परिभाषित करना पड़ता था।
डीप लर्निंग दृष्टिकोण: यह एंड-टू-एंड (End-to-End) लर्निंग पर काम करता है, जहाँ मॉडल स्वयं कच्चे गैर-संरचित डेटा (Raw Data) से स्वतः ही विशेषताओं को सीखता है और निकालता है।
इसी अद्वितीय क्षमता ने डीप लर्निंग को कंप्यूटर विज़न, स्पीच रिकग्निशन और नेचुरल लैंग्वेज प्रोसेसिंग जैसी अत्यधिक जटिल समस्याओं को हल करने में अभूतपूर्व सफलता दिलाई।
न्यूरल नेटवर्क की मजबूत वापसी (Resurgence of Neural Networks)
1980 के दशक में, वैज्ञानिकों जेफ्री हिंटन (Geoffrey Hinton), डेविड रुमेलहार्ट (David Rumelhart) और रोनाल्ड विलियम्स ने बैकप्रोपेगेशन (Backpropagation) एल्गोरिदम को व्यापक रूप से विकसित और लोकप्रिय बनाया। यह बहुस्तरीय न्यूरल नेटवर्क को प्रशिक्षित करने की एक अत्यंत कुशल गणितीय विधि थी। हालांकि, उस युग में कंप्यूटरों की गति और उपलब्ध डेटा की मात्रा इतनी नहीं थी कि अत्यधिक विशाल नेटवर्क को व्यावहारिक रूप से चलाया जा सके।
2000 के दशक में, GPU चिप्स की बढ़ती कम्प्यूटेशनल क्षमता और इंटरनेट पर बड़े डेटासेट की उपलब्धता के साथ, शोधकर्ताओं ने पुनः इस दृष्टिकोण पर ध्यान केंद्रित किया। इसके परिणामस्वरूप गहरे न्यूरल नेटवर्क का कुशलतापूर्वक प्रशिक्षण संभव हो सका, जिसने डीप लर्निंग (Deep Learning) क्रांति की मजबूत नींव रखी।
ImageNet परियोजना: 2012 का ऐतिहासिक विस्फोट (The ImageNet Landmark: 2012)
एआई के कई इतिहासकार 2012 को डीप लर्निंग क्रांति का आधिकारिक शुरुआत वर्ष मानते हैं। इस वर्ष, एलेक्स क्रिजहेव्स्की (Alex Krizhevsky), इल्या सुतस्केवर (Ilya Sutskever) और जेफ्री हिंटन (Geoffrey Hinton) ने AlexNet नामक एक मॉडल विकसित किया और इसे अंतर्राष्ट्रीय इमेजनेट (ImageNet) प्रतियोगिता में प्रस्तुत किया।
AlexNet ने कन्वोल्यूशन न्यूरल नेटवर्क (CNN) और GPU चिप्स की समानांतर शक्ति का उपयोग करके छवि पहचान में त्रुटि दर को आश्चर्यजनक रूप से घटा दिया। इस मॉडल ने अपने सभी पारंपरिक प्रतिस्पर्धियों को भारी अंतर से हरा दिया। इस ऐतिहासिक सफलता ने सिद्ध कर दिया कि डीप लर्निंग वास्तविक दुनिया की जटिल समस्याओं में पारंपरिक तरीकों से कहीं अधिक शक्तिशाली है, जिसके परिणामस्वरूप वैश्विक विश्वविद्यालयों, प्रौद्योगिकी दिग्गजों और निवेशकों ने इस क्षेत्र में अभूतपूर्व पूंजी का निवेश किया।
डीप लर्निंग मॉडलों का विकास (Evolution of Deep Learning Architectures)
AlexNet की सफलता के बाद, न्यूरल नेटवर्क के कई विशिष्ट आर्किटेक्चर विकसित हुए, जिन्होंने विभिन्न क्षेत्रों में क्रांतिकारी बदलाव किए:
कन्वोल्यूशन न्यूरल नेटवर्क (CNNs): विशेष रूप से कंप्यूटर विज़न, छवि पहचान, वीडियो विश्लेषण और मेडिकल इमेजरी के लिए।
रिकरेंट न्यूरल नेटवर्क (RNNs): क्रमिक (Sequential) डेटा, जैसे पाठ और प्राकृतिक भाषा प्रसंस्करण के लिए।
LSTM (Long Short-Term Memory) नेटवर्क: लंबी श्रृंखलाओं वाले डेटा और वाक्यों को बिना शुरुआती जानकारी भूले बेहतर ढंग से समझने के लिए।
ट्रांसफॉर्मर नेटवर्क (Transformer Networks): 2017 में गूगल द्वारा प्रस्तुत किए गए, जिन्होंने自注意力 (Self-Attention) तंत्र की शुरुआत की। यह आर्किटेक्चर आज के बड़े भाषा मॉडलों (LLMs) और जेनेरेटिव एआई (Generative AI) की मूल नींव है।
डीप लर्निंग का व्यावहारिक और सामाजिक प्रभाव (Practical Impact of Deep Learning)
डीप लर्निंग ने कई महत्वपूर्ण और संवेदनशील क्षेत्रों में वास्तविक और मौलिक परिवर्तन किए हैं:
कंप्यूटर विज़न: स्मार्टफोन में चेहरा पहचान (Face Recognition), मेडिकल एक्स-रे और एमआरआई का विश्लेषण, और स्वायत्त वाहनों (Self-Driving Cars) का नेविगेशन।
प्राकृतिक भाषा प्रसंस्करण (NLP): वास्तविक समय बहुभाषी अनुवाद, लंबे पाठ का स्वचालित सारांश, और चैटबॉट्स (जैसे ChatGPT)।
आवाज पहचान: बुद्धिमान आवाज सहायकों (Voice Assistants) का संचालन और स्पीच-टू-टेक्स्ट तकनीक।
स्वास्थ्य और औषधि: कैंसर का शुरुआती निदान, डीएनए (DNA) अनुक्रमण विश्लेषण, और नई औषधियों के अणुओं की खोज।
उद्योग और वाणिज्य: बाजार की मांग का पूर्वानुमान, गुणवत्ता नियंत्रण का स्वचालन, और वैयक्तिकृत सिफारिश प्रणालियां।
डीप लर्निंग की सीमाएं और चुनौतियां (Limitations and Challenges)
इन सभी महान उपलब्धियों के बावजूद, डीप लर्निंग की अपनी कुछ गंभीर सीमाएं और चुनौतियां हैं:
अत्यधिक डेटा और कम्प्यूटेशनल लागत: इन मॉडलों को प्रशिक्षित करने के लिए विशाल डेटासेट और अत्यधिक महंगे व ऊर्जा-गहन कम्प्यूटेशनल बुनियादी ढांचे की आवश्यकता होती है।
"ब्लैक बॉक्स" समस्या (Black Box Problem): अधिकांश गहरे मॉडल अपनी जटिल आन्तरिक गैर-रेखीय संरचना के कारण पारदर्शी नहीं होते हैं; यानी यह सटीक रूप से विश्लेषण करना कठिन होता है कि मॉडल ने आंतरिक रूप से कोई निर्णय कैसे लिया। यह अस्पष्टता चिकित्सा, न्याय और वित्तीय जोखिम जैसे महत्वपूर्ण क्षेत्रों में विश्वास और जवाबदेही के बड़े सवाल खड़े करती है।
जनरेटिव एआई (Generative AI) और ChatGPT: नई सामग्री निर्माण का युग
2010 के दशक के अंत और 2020 के दशक की शुरुआत में, कृत्रिम बुद्धिमत्ता ने एक नए और अभूतपूर्व चरण में प्रवेश किया जिसे जनरेटिव एआई (Generative AI) के नाम से जाना जाता है। पिछले युगों की तुलना में इसका मौलिक अंतर यह है कि ये प्रणालियां केवल डेटा का विश्लेषण या वर्गीकरण करने वाले उपकरण नहीं हैं, बल्कि वे स्वयं नए पाठ, चित्र, ऑडियो, वीडियो और प्रोग्रामिंग कोड जैसी पूरी तरह से नई सामग्री उत्पन्न कर सकती हैं।
जनरेटिव एआई क्या है? (What is Generative AI?)
जनरेटिव एआई कृत्रिम बुद्धिमत्ता की एक उन्नत शाखा है जिसमें मॉडलों को विशाल डेटासेट के भीतर छिपे पैटर्न और सम्भाव्यता वितरणों को सीखने के लिए प्रशिक्षित किया जाता है। इसके आधार पर, ये मॉडल इनपुट निर्देशों (Prompts) के जवाब में नई सामग्री का निर्माण करते हैं, न कि केवल पिछले डेटा की नकल।
हार्डवेयर बुनियादी ढांचा और बड़े भाषा मॉडलों (LLMs) की छलांग
बड़े भाषा मॉडलों और जनरेटिव एआई का विकास कंप्यूटर हार्डवेयर में आई बड़ी छलांग के बिना असंभव था। इन विशाल मॉडलों को प्रशिक्षित करने के लिए हजारों उच्च-प्रदर्शन GPU चिप्स की आवश्यकता होती है जो समानांतर में एक साथ काम करते हैं।
वर्तमान में, NVIDIA कंपनी की उन्नत चिप्स (जैसे A100 और H100) वैश्विक एआई बुनियादी ढांचे की रीढ़ मानी जाती हैं। कंपनी के CUDA प्लेटफॉर्म ने शोधकर्ताओं को वैज्ञानिक संगणना और एआई मॉडलों के लिए GPU की शक्ति का उपयोग करने की अनुमति दी, जिसके आधार पर आज की अधिकांश जनरेटिव एआई सेवाएं संचालित हो रही हैं।
बड़े भाषा मॉडलों का उदय और क्षमताएं (Large Language Models - LLMs)
ट्रांसफॉर्मर (Transformer) आर्किटेक्चर के आधार पर बड़े भाषा मॉडलों का विकास हुआ। इन मॉडलों को अरबों शब्दों और विशाल टेक्स्ट语料库 पर प्रशिक्षित किया जाता है, जिससे वे प्राकृतिक भाषा के जटिल संदर्भों और अमूर्त विचारों को समझ सकते हैं।
बड़े भाषा मॉडल निम्नलिखित कार्यों को सफलतापूर्वक निष्पादित कर सकते हैं:
जटिल प्रश्नों के तार्किक उत्तर देना;
नई सामग्री लिखना और लंबे दस्तावेजों का सटीक सारांश तैयार करना;
विभिन्न भाषाओं के बीच प्रवाहपूर्ण स्वचालित अनुवाद;
सॉफ्टवेयर कोड लिखना, डिबग (Debug) करना और समझाना;
व्याकरणिक और भाषाई त्रुटियों को सुधारना;
वैज्ञानिक अनुसंधान और जटिल समस्या-समाधान में सहायता करना।
ChatGPT मॉडल: मानव-मशीन संवाद का नया प्रतिमान
ChatGPT जनरेटिव एआई का सबसे प्रसिद्ध और व्यापक रूप से उपयोग किया जाने वाला अनुप्रयोग है। OpenAI द्वारा विकसित यह प्रणाली GPT (Generative Pre-trained Transformer) मॉडल श्रृंखला पर आधारित है।
जब 30 नवंबर 2022 को ChatGPT को सार्वजनिक रूप से जारी किया गया, तो इसने केवल कुछ ही दिनों में दुनिया भर के लाखों उपयोगकर्ताओं को आकर्षित किया। इस सफलता ने साबित किया कि मानवता एआई को सीखने, लिखने, कोडिंग और अनुवाद के लिए एक दैनिक उपकरण के रूप में अपनाने के लिए तैयार है।
ChatGPT की सफलता का मुख्य रहस्य: विशाल डेटा पर पूर्व-प्रशिक्षण (Pre-training) के अलावा, यह मॉडल मानव प्रतिक्रिया से सुदृढ़ीकरण सीखने (Reinforcement Learning from Human Feedback - RLHF) तकनीक का उपयोग करता है। इस तकनीक ने मॉडल के उत्तरों को मानव संवाद शैली के साथ अत्यधिक सटीक, संगठित और संरेखित बनाया है।
जनरेटिव एआई के बहुआयामी अनुप्रयोग (Applications of Generative AI)
जनरेटिव एआई ने प्रमुख उद्योगों में क्रांतिकारी बदलाव किए हैं:
शिक्षा: पाठ सार तैयार करना, कठिन वैज्ञानिक अवधारणाओं को समझाना, और वैयक्तिकृत ट्यूटर के रूप में कार्य करना।
स्वास्थ्य सेवा: डॉक्टरों को मेडिकल रिपोर्ट लिखने में सहायता करना और रोगी डेटा का विश्लेषण करना।
सॉफ्टवेयर इंजीनियरिंग: कोड लिखने, डिबगिंग करने और सॉफ्टवेयर आर्किटेक्चर को समझाने में डेवलपर्स की सहायता करना।
डिजिटल मीडिया: त्वरित समाचार आलेख लिखना, सामग्री निर्माण, और डिजिटल कला।
व्यापार और विपणन: विज्ञापन प्रतिलिपि (Ad Copy) बनाना, स्वचालित ग्राहक सेवा, और बाजार रणनीतियों का विश्लेषण।
कला और डिज़ाइन: रचनात्मक चित्र, संगीत, वीडियो और दृश्य डिज़ाइन तैयार करना।
संदर्भ एवं ग्रंथ सूची (Academic Bibliography)
Russell, S., & Norvig, P. (2021). Artificial Intelligence: A Modern Approach (4th ed.). Pearson.
Turing, A. M. (1936). On Computable Numbers, with an Application to the Entscheidungsproblem. Proceedings of the London Mathematical Society, 2(42), 230–265.
Turing, A. M. (1950). Computing Machinery and Intelligence. Mind, 59(236), 433–460.
McCorduck, P. (2004). Machines Who Think: A Personal Inquiry into the History and Prospects of Artificial Intelligence (2nd ed.). A K Peters.
Nilsson, N. J. (2010). The Quest for Artificial Intelligence: A History of Ideas and Achievements. Cambridge University Press.
al-Jazarī, I. (1974). The Book of Knowledge of Ingenious Mechanical Devices (D. R. Hill, Trans.). D. Reidel Publishing Company.
Hill, D. R. (1998). Mechanical Engineering in the Medieval Near East. Scientific American, 264(5), 100–105.
Hill, D. R. (1991). Islamic Science and Engineering. Edinburgh University Press.
Encyclopaedia Britannica. al-Jazari.
Ceccarelli, M. (2004). Distinguished Figures in Mechanism and Machine Science. Springer.
कृत्रिम बुद्धिमत्ता का इतिहास
Rebaz Ahmed
लेख के लेखक