完整译文尚未就绪,本页暂时以英文显示。
返回学术人工智能发展史 (History of Artificial Intelligence)
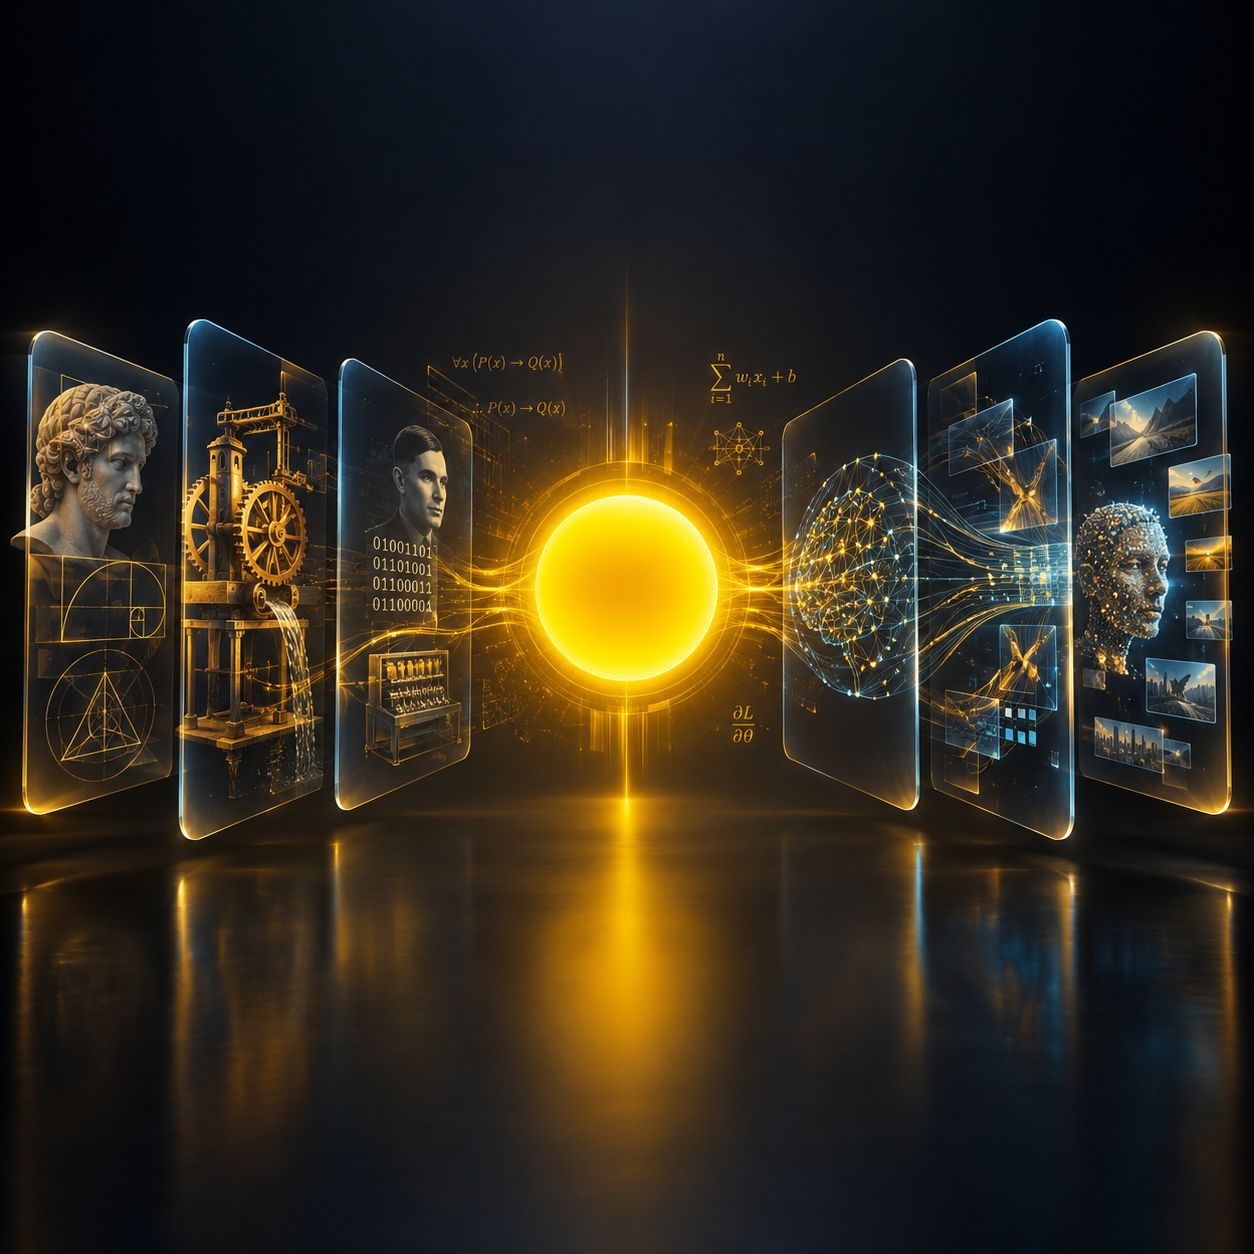
创造能够具备类人思维与决策能力的机械,并非始于现代计算机的出现,其思想根源可追溯至数千年前。纵观人类历史,哲学家、思想家及科学家持续探索着两个核心问题:“智能的本质是什么?”以及“智能能否被人工构建?”。这些理论追问,构成了后世人工智能(AI)学科诞生的认知基石。
在古希腊时期,柏拉图(Plato)与亚里士多德(Aristotle)等哲学家高度重视逻辑学、结构化思维及知识获取的方法论。亚里士多德首次构建了形式逻辑体系,确立了演绎推理(Syllogism)的基本律则。这些早期探索虽然未直接创造出人工智能,但确立了明确的理论范式:人类的思维过程可通过确切的规则与原理进行符号化描述。
中世纪至近代早期,数学家与哲学家开始系统化推进逻辑学与数学的融合。17世纪,高特弗里德·威廉·莱布尼茨(Gottfried Wilhelm Leibniz)提出了用于逻辑推理与概念表征的通用符号语言。他设想,若将所有思维活动转化为数学律则,未来的计算表征计算设备便能通过代数运算解决复杂问题。尽管受限于当时的工程水平该设想未能实现,但它成为了人工智能重要的唯理主义思想源头。
19世纪,计算技术与自动化工程取得突破性进展。查尔斯·巴贝奇(Charles Babbage)设计了“分析机”(Analytical Engine),该设计已具备现代计算机的核心要素,包括存储器(Memory)、算术逻辑单元(ALU)及可编程性。虽然该原型机未能完全竣工,但科技史学界普遍将其视为首个通用计算机的工程蓝图。
同一时期,被誉为人类历史上首位程序员的爱达·勒芙蕾丝(Ada Lovelace)提出了具有远见卓识的论断。她预见,未来的计算设备将超越单纯的数值计算,进而具备处理音乐、图像及多元非结构化数据的能力。这一前瞻性构想,对后续人工智能概念的拓宽产生了深远影响。
20世纪初,形式逻辑与数学基础理论加速演进。乔治·布尔(George Boole)创立的布尔代数,以及哥特洛布·弗雷格(Gottlob Frege)、伯特兰·罗素(Bertrand Russell)和阿尔弗雷德·诺斯·怀特海(Alfred North Whitehead)的后续研究,为数理逻辑奠定了坚实的理论架构。这些成果论证了:人类思维的特定逻辑范式可以被形式化规则所归纳,并由机械化系统执行。
该阶段最关键的范式转移源于阿兰·图灵(Alan Turing)的开创性贡献。1936年,图灵在其里程碑式论文 On Computable Numbers, with an Application to the Entscheidungsproblem 中提出了“图灵机”(Turing Machine)的抽象数学模型。他证明了:任意可以被算法精确描述的计算过程,皆可由一台通用图灵机实现。这一理论直接奠定了计算科学与人工智能的数学基础。
第二次世界大战后,电子计算机的问世为这些理论的落地提供了硬件载体。1950年,图灵在 Mind 期刊发表了经典论文 Computing Machinery and Intelligence,抛出了划时代的命题:“机器能否思考?”("Can machines think?")。同时,他提出了用于评估计算机系统是否具备人类行为等效性的实证方法——即后来的“图灵测试”(Turing Test)。
从古希腊逻辑学、莱布尼茨的数理哲学、巴贝奇的分析机、爱达的计算构想,到图灵的计算理论,这些学术积淀为人工智能的诞生提供了坚实的科学与理论支撑。最终,在1956年的达特茅斯会议(Dartmouth Conference)上,人工智能被正式确立为一门独立的学术学科,开启了科技史的新纪元。
阿尔-扎扎里与早期自动机工程 (Al-Jazari and Automata)
在人工智能学科正式确立的数个世纪前,人类在机械自动化与自律运行系统领域的工程探索,为后来的机器人学及机械工程学奠定了深厚的实践基础。该领域最具代表性的先驱之一,是生活于公元1136至1206年间的杰出工程师巴迪·扎曼·阿布·伊斯梅尔·本·拉扎兹·阿尔-扎扎里(Ismail al-Jazari)。扎扎里在位于库尔德斯坦北部的阿米德(现迪亚巴克尔)集聚学术成就,并在阿图格王朝(Artuqid)担任首席宫廷工程师长达近半个世纪。
公元1206年,扎扎里撰写完成了极其重要的工程学巨著《精巧机械装置的知识之书》(The Book of Knowledge of Ingenious Mechanical Devices)。该著作被视为机械工程史上最具学术价值的历史文献之一,书中通过详尽的图表与精确的技术说明,记载了约50种自动化机械装置。其发明涵盖复杂的水钟、双作用液压泵(Double-acting Pump)、自动侍从、机械洗手装置及自动化乐队等,这些装置完全依赖流体力学、重力及凸轮机构(Cam Mechanism)实现无干预的自动运转。
众多科技史学家将扎扎里尊为“机械工程与自动化控制理论之父”之一;他所创新的工程机制对后续机器人学与自动化控制系统的演进产生了深远影响。尽管扎扎里的机械装置尚未具备现代意义上的人工智能(缺乏自我学习、自主决策与环境适应能力),但其开创性的工程实践,被公认为人类构建类人自动机与自律系统进程中极其关键的历史里程碑。
阿兰·图灵与图灵测试 (Alan Turing and the Turing Test)
阿兰·麦席森·图灵(1912–1954)被公认为计算科学与人工智能学科的核心奠基人。他的理论研究不仅确立了计算理论的科学范式,亦开辟了评估机械系统模拟人类智能行为的新路径。此外,图灵在二战期间主持破解了德军的“英格玛”(Enigma)密码,对盟军的胜利及现代电子计算机的研制产生了关键决定性作用。
图灵机模型与计算科学奠基
1936年,图灵发表了划时代的理论论文 On Computable Numbers, with an Application to the Entscheidungsproblem,并在其中建立了“图灵机”(Turing Machine)这一抽象数学模型。
该模型并非实体机械,而是一个图灵定义的数学构架,用以阐明任意逻辑过程如何被分解为可执行的离散步骤。图灵机的科学意义在于证明了算法可计算性的边界:即任何可被算法化表述的问题,理论上均可由通用图灵机予以求解。这一理论构成了现代计算机科学及人工智能算法的基石。
“机器能否思考?”
1950年,图灵在哲学期刊 Mind 上发表了另一篇具有深远影响的论文 Computing Machinery and Intelligence,文章开篇即提出了直击本质的问题:
"Can machines think?"(“机器能否思考?”)
图灵认为,“思考”一词在语义与概念层面过于模糊,难以进行严谨的科学界定。因此,他主张将这一抽象的形而上学问题,转化为一项可操作、可观察的行为表征测试。
图灵测试(The Turing Test)
图灵最初将该实验命名为“模仿游戏”(Imitation Game),后在学术界被广泛称为“图灵测试”(Turing Test)。该测试包含三个核心主体:
人类受试者(作为基准对照);
待评估的计算机/人工智能系统(尝试模拟人类自然语言行为);
位于隔离环境中的人类评估员(在隐蔽测试条件下进行判定)。
评估员仅通过纯文本交互界面向两方提问。若在测试周期结束后,评估员无法以显著的统计置信度区分机器与人类,则判定该人工智能系统通过了图灵测试。
学术注脚: 该测试的本质并非用以证实机器具备“主观意识”或“情感感知”,其核心目的在于评估机械系统在语言交互行为层面达到人类同等智能表征的程度。
对人工智能演进的学术影响
图灵测试成为了人工智能发展史上最具里程碑意义的操作性定义之一。它首次为智能系统的行为评估提供了标准化的实证框架。这一范式深度引导了1950年代以后的AI研究走向,直接推动了对话系统(Chatbots)、知识问答系统以及现代大语言模型(LLMs)的技术演进。
进入21世纪,随着生成式大语言模型与多模态AI的突破,关于图灵测试的学术讨论重新成为焦点。尽管部分前沿系统已能在短期对话中展现出高度逼真的人类交互特征,但学术界普遍达成共识:仅通过行为层面的图灵测试,并不等同于系统具备了通用人工智能(AGI)或自我意识。系统完全可以在缺乏真实语义理解、情绪感知及自我觉知的前提下,通过模式匹配与概率生成实现高度拟人化的行为表达。
学术批判与理论局限
尽管图灵测试具有巨大的历史与范式价值,但它也面临着来自认知科学与哲学界的深刻批判。其中最具代表性的是哲学家约翰·塞尔(John Searle)提出的“中文屋”(Chinese Room)思想实验。塞尔以此证明:一个系统可以完全依据形式语法规则处理符号输入与输出,而无需对符号背后的真实语义(Semantics)产生任何内在理解。此外,认知科学界的普遍共识指出,人类智能绝非仅局限于语言符号的转换,它与具身认知、情境感知、创造性联想、自主决策以及与物理世界的实时交互存在着不可分割的深度绑定。
达特茅斯会议与人工智能的正式确立 (The Dartmouth Conference and the Formal Birth of AI)
大多数计算机史学家与学术界普遍将11956年视为人工智能(Artificial Intelligence, AI)作为一门独立学科的正式立宗之年。是年夏季,在美国新罕布什尔州达特茅斯学院(Dartmouth College)召开了一场开创性的学术研讨会,史称“达特茅斯人工智能夏季研究项目”(Dartmouth Summer Research Project on Artificial Intelligence)。
该会议代表了国际学术界首次系统化地构建一门独立学科的尝试,旨在专门探究如何构建具备智能行为表征的计算系统。
项目起源与学术先驱 (Origins and Pioneers)
该研讨会的构想最早由后来被誉为“人工智能之父”的约翰·麦卡锡(John McCarthy)提出。与他共同撰写立项提案的先驱还包括:马文·明斯基(Marvin Minsky)、IBM公司的纳撒尼尔·罗切斯特(Nathaniel Rochester),以及信息论(Information Theory)的奠基人克劳德·香农(Claude Shannon)。
立项申请书中载明了如下核心学术假说:
“学习的任意维度或智能的任意特征,原则上皆可被精确描述,以至于可以制造出机械系统来进行精确模拟。”
这一论断构成了当时AI学术界的理论范式与思想基石。学者们普遍确信:人类智能的核心机制可通过形式化规则、算法及计算能力进行精确定义,并最终由计算机系统加以实现。
“Artificial Intelligence” 术语的诞生 (Birth of the Term "Artificial Intelligence")
达特茅斯会议最重要的历史性成果之一,在于约翰·麦卡锡首次在学术规范层面正式提出了 “Artificial Intelligence”(人工智能) 这一学术术语。在此之前,该领域的探索多散见于网络控制论(Cybernetics)、自动机理论(Automata Theory)或复杂信息处理(Complex Information Processing)等不同学科门类之下。
这一新术语的选定具备明确的学科战略考量:麦卡锡意在明确区分该领域与其他既有学科的边界,从而确立其独立的学术身份与研究范式。因此,11956年不仅是一次学术会议的召开之年,更是这一崭新科学门类的正式诞生日。
研讨会的学术目标 (Primary Objectives of the Conference)
参会的学术先驱们抱持高度乐观的学术预判,设想在数年之内即可攻克人类智能的核心机制。其设定的主要技术攻关目标包括:
研发自动学习(机器学习)系统;
自然语言理解与处理(Natural Language Processing, NLP);
问题求解与决策机制的形式化;
抽象逻辑思维的形式化表征;
图像识别与感知能力的构建;
创造能够完全展现人类等效行为的综合机械系统。
虽然当时的学者设想这些目标将在短期内实现,但后续的发展历程表明,人类智能的内在复杂度与机制深度远超初始阶段的理论构想。
学术影响与科研生态构建 (Academic Impact and Institutional Support)
尽管达特茅斯会议本身并未直接产出重大的工程突破,但其对计算机科学发展方向的引导作用是里程碑式的。会议召开后,全球顶尖学术机构纷纷设立了专门的人工智能实验室,其中包括麻省理工学院(MIT)、斯坦福大学(Stanford University)以及卡耐基梅隆大学(Carnegie Mellon University)。
与此同时,美国政府及其国防高级研究计划局(DARPA)等机构向该新兴领域注入了巨额科研资助。这些资金支持成为了推动早期智能程序研发与机器学习理论演进的核心引擎。
早期开创性成果:1950–1960年代 (Early Breakthroughs: 1950s–1960s)
在1950年代下半叶至1960年代初,学术界涌现出一批具有开创意义的研究项目,其中代表性的成果包括:
逻辑理论家(Logic Theorist, 1956): 由艾伦·纽厄尔(Allen Newell)与赫伯特·西蒙(Herbert A. Simon)开发。该程序被公认为历史上首个人工智能程序,具备证明符号逻辑定理的能力。
通用问题求解器(General Problem Solver, GPS): 构建通用逻辑问题求解范式的一次先驱性工程尝试。
LISP 编程语言(1958): 由约翰·麦卡锡发明。在随后的数十年中,LISP长期作为全球AI学术研究与程序开发的首选核心语言。
这些早期工程探索虽受限于算力规模,但实证了计算系统具备执行符号逻辑推理任务的技术可行性。
人工智能之冬 (AI Winters)
在1950年代末至1960年代初取得早期突破后,学术界与资助机构曾普遍预测计算机将在短期内全面实现人类水准的智能任务。然而,这种高度乐观的预期与当时实际的技术工程能力之间存在巨大鸿沟。
预期与现实严重脱节的后果,导致科研资金、公众信任与研究活动出现了周期性的严重衰退。在科技史中,这些停滞与低谷期被学术界统称为“人工智能之冬”(AI Winters)。
“AI之冬”这一术语泛指由于工程落地成果未能达到学者与企业前期宣称的高预期,进而引发科研资助大幅缩减、公众信任崩塌的历史周期。AI之冬是人工智能演进史上极其关键的范式转型期,它迫使学术界重新审视其理论假设与技术路线。
第一次人工智能之冬:1970年代 (The First AI Winter: 1970s)
第一次AI之冬始于1960年代末至1970年代初。在此期间,尽管 Logic Theorist、GPS 及 ELIZA 等早期程序引发了公众与学术界的广泛关注,但其功能局限在高度人工定制的实验室环境下,面对真实世界的复杂非结构化问题时表现出严重的泛化失效。
《感知机》著作的出版(Perceptrons, 1969): 马文·明斯基(Marvin Minsky)与西蒙·派珀特(Seymour Papert)出版了标志性著作 Perceptrons,从数学层面严谨论证了单层人工神经网络(感知机)的理论极限。尽管其学术批判完全严谨,但资助机构普遍将其解读为神经网络路线的彻底终结,直接导致该领域的学术研究停滞了近二十年。
莱特希尔报告(Lighthill Report, 1973): 英国政府发布了由数学家詹姆斯·莱特希尔爵士(Sir James Lighthill)主笔的战略评估报告。报告对AI领域缺乏实际工程价值与理论瓶颈进行了尖锐批评。报告发布后,英国大部分AI科研项目被直接取消资助,并在国际学术界引发了连锁负面反应。
理论复兴与新曙光:1980年代 (The Revival of Hope: 1980s)
进入1980年代,由于专家系统(Expert Systems)在商业领域的成功落地,人工智能重新获得了企业与政府的深度关注。专家系统通过归纳特定领域的专家知识与推理规则,用于辅助特定场景的决策与诊断。诸如数字设备公司(DEC)与IBM等科技巨头在此领域投入了大量资本。
与此同时,日本政府启动了宏大的国家级项目——“第五代计算机系统项目”(Fifth Generation Computer Systems, FGCS),旨在研发具备超高智能的并行计算系统。这些举措重新激发了产业界与学术界对人工智能未来前景的热情。
第二次人工智能之冬:1980年代末至1990年代初 (The Second AI Winter: Late 1980s–Early 1990s)
尽管1980年代前期存在高度乐观的产业预期,但在1980年代末,人工智能再次触及技术与工程的坚硬壁垒。实证表明,专家系统(Expert Systems)存在建造与维护成本极高、知识库更新维护极其繁琐,且在面对动态变化与非结构化环境时泛化能力严重不足等固有缺陷。
与这一困境同步发生的是,个人计算机(PC)市场迎来了爆发式增长。众多企业开始转向更为经济高效的通用硬件与软件解决方案,而不再依赖昂贵且专用的人工智能硬件。这一市场范式的转移,导致大量AI初创企业破产清算,科研资助再次出现大规模缩减。这一阶段在科技史中被记录为第二次人工智能之冬。
AI之冬爆发的核心诱因 (Key Causes of AI Winters)
纵观历史,一系列深层次的结构性因素交织演变,共同引发了这些停滞期:
过度宣扬与非理性预期: 过于乐观地设想在短期内即可实现人类水准的通用智能(AGI)。
计算硬件能力的物理瓶颈: 当时算力系统的处理速度与内存容量,远远无法满足复杂认知任务的计算需求。
高质数据集的极度匮乏: 缺少训练高泛化性模型所需的规模化、高质量数据集。
早期算法范式的理论局限: 缺乏类似现代深度学习的高维特征萃取与表征算法。
受控实验室环境与复杂现实世界的割裂: 系统在高度可控的试验环境中表现良好,但在面对现实世界的噪声与不确定性时极易失效。
资本与资助方的信任崩塌: 在宏大产业承诺屡屡落空后,政府机构与企业资本选择大规模撤资。
机器学习的兴起 (The Rise of Machine Learning)
在历经两次“AI之冬”的洗礼后,学术界深刻认识到:早期占据主导地位的基于符号与硬编码规则的传统范式(Rule-Based Systems)存在着不可逾越的理论边界。在现实世界的绝大多数复杂场景中,依靠人类专家穷举所有规则与逻辑分支是不可行的,因为现实环境、上下文及数据流始终处于动态演进之中。
基于这一认知突破,人工智能研究迎来了一场范式革命——机器学习(Machine Learning, ML)应运而生。在这一新范式下,计算机不再被动等待人类编写确切的指令算法,而是通过数据驱动,自主从数据中萃取规律、推演模式并执行特定任务。
硬件革新与算力飞跃 (The Role of Hardware Advances)
机器学习的演变不仅依赖于算法理论的创新,计算硬件的工程突破同样发挥了决定性的引擎作用。在1990年代至2000年代初,以英特尔(Intel)和超威半导体(AMD)为代表的半导体巨头,推动中央处理器(CPU)的处理性能与主频实现了指数级增长。这一硬件飞跃为训练更复杂的统计模型及处理海量数据集提供了算力保障,尽管在当时,全局计算速度依然存在一定的物理限制。
机器学习的概念与定义 (Concept and Definition of Machine Learning)
机器学习是人工智能领域的核心分支,其研究旨在构建能够自主从数据中进行归纳与泛化的软件系统及算法模型,使其具备识别潜在模式、建立隐性关联并进行精准预测或决策的能力,而无需人类程序员针对特定场景编写明确的处理逻辑。
人工智能先驱亚瑟·萨缪尔(Arthur Samuel)于1959年为该领域给出了最为经典的定义:
“机器学习是一门赋予计算机在无需进行显式编程的前提下具备学习能力的科学领域。”
推动机器学习崛起的关键驱动力 (Drivers of Machine Learning Adoption)
在1980年代末及1990年代,多维度的结构性变革共同促成了机器学习的蓬勃发展:
数字信息的爆炸式增长: 互联网早期普及催生了首批大规模标准数据集(Datasets)的建立。
硬件性能的阶跃: 计算处理速度的提升与存储成本的显著下降。
基础学科的理论突破: 概率论、数理统计及优化理论在计算科学中的深度融合。
产业界的强劲需求: 市场对于数据分类、预测分析、图像识别与语音处理的工程化需求急剧增加。
这些因素促使研究人员从编写数万行硬编码规则,转向构建极具弹性的统计模型,由模型自身在数据海洋中寻找最优解。
机器学习的核心学习范式 (Major Paradigms of Machine Learning)
机器学习技术体系在学术与工程层面主要划分为三大基本范式:
监督学习(Supervised Learning): 在该范式下,模型基于包含明确真值标签(Labels)的训练集进行拟合。其核心目标是学习输入特征与输出标签之间的映射函数,以实现对未见新数据的精准预测。
典型工程应用: 房价预测、垃圾邮件智能过滤、医疗影像辅助诊断。
无监督学习(Unsupervised Learning): 给定模型的训练数据不包含任何预设标签或真值。算法需依靠自身机制,自主挖掘数据内部的隐性结构、流形分布或聚类关联。
典型工程应用: 客户群体画像分割、异常行为与欺诈检测(Anomaly Detection)、高维数据降维(Dimensionality Reduction)。
强化学习(Reinforcement Learning): 在该范式中,智能体(Agent)通过在动态环境中执行动作并接受环境的反馈(即奖励 Reward 或惩罚 Penalty),利用试错(Trial and Error)机制进行策略迭代。随着时间推移,智能体将自主求解出最大化累积奖励的最优行为策略。
典型工程应用: 复杂博弈决策(如电子竞技与围棋)、机器人控制学、自动驾驶路径规划、自动化网络调度。
算法演进与神经网络的复兴 (Algorithmic Evolution and the Resurgence of Neural Networks)
在1990年代至2000年代,一系列卓越的经典机器学习算法相继成熟,奠定了现代统计学习的技术基石,其中包括:决策树(Decision Trees)、随机森林(Random Forests)、支持向量机(Support Vector Machines, SVM)、朴素贝叶斯(Naïve Bayes)以及k-近邻算法(k-Nearest Neighbors, k-NN)。这些算法在金融计量、临床医学及自然语言处理等领域取得了广泛的工程成功。
与此同时,尽管人工神经网络在经历了“第一次AI之冬”后一度边缘化,但杰弗里·辛顿(Geoffrey Hinton)、戴维·鲁梅哈特(David Rumelhart)及罗纳德·威廉姆斯(Ronald Williams)等学者在1980年代至1990年代对反向传播算法(Backpropagation)进行的持续性与系统性研究,重新将学术界与工程界的光芒引回至神经网络路线。反向传播算法为多层前馈神经网络的参数优化提供了严谨的数学解法,最终成为了后续深度学习(Deep Learning)革命的核心基石。
“大数据”范式与 GPU 算力芯片的兴起 (The Convergence of Big Data and GPU Acceleration)
进入21世纪初,伴随互联网的全面普及、社交网络平台、智能移动终端及各类数字化服务的指数级爆发,全球数据生成量呈几何级数激增,标志着大数据(Big Data)时代的正式到来。
由于机器学习模型的泛化能力与参数收敛高度依赖于规模化训练数据,大数据的涌现为该领域的飞跃提供了最为关键的数据燃料。与数据爆发同步发生的是算力架构的深刻变革——计算范式从中央处理器(CPU)向图形处理器(GPU)加速迁移,结合并行计算(Parallel Computing)技术的创新突破,使得原本需要耗时数月的大规模模型训练任务,被大幅压缩至数天乃至数小时内高效完成。
机器学习对科技未来演进的深远影响 (The Strategic Impact of ML)
机器学习范式的崛起,彻底重塑了人工智能的研究路线图与学术范式。这一理论与工程层面的范式转移,直接赋能并驱动了当今社会日常应用中诸多核心技术的落地,例如:
个性化推荐系统: 如 Netflix 与 Spotify 的用户兴趣与内容协同过滤引擎;
实时机器翻译: 跨语言自然语言处理与多语种即时转化;
多模态感知技术: 语音识别、人脸识别与计算机视觉应用;
计算医学与精准医疗: 重大疾病的早期临床预测与影像辅助诊断;
商业智能与安全防护: 自动化风控、商务决策支持与高精度垃圾邮件过滤。
更为至关重要的是,机器学习充当了坚实的理论与工程桥梁,直接催生并铺平了深度学习(Deep Learning)与生成式人工智能(Generative AI)的前沿演进道路,推动人类科技正式迈向当今智能化变革的最高峰。
深度学习革命:人工智能的巅峰变革 (The Deep Learning Revolution)
深度学习(Deep Learning)被公认为人工智能演化史上最具深远影响力的重大里程碑之一。尽管人工神经网络(Artificial Neural Networks, ANNs)的理论范式早在1940年代与1950年代即已奠定,但在随后漫长的数十年间,受限于计算硬件的物理瓶颈、高质训练数据的匮乏以及深层网络参数优化的梯度消失等数学难题,该路线的发展长期受阻。
直至21世纪初,三大关键要素实现了历史性的交汇——数字化海量数据(Big Data)的积累、图形处理器(GPUs)的并行算力突破,以及新型神经网络训练算法的演进。三者深度融合,共同驱动深度学习成为了全球人工智能技术飞跃的主导引擎与核心推动力。
硬件架构范式的重塑:从 CPU 到 GPU 的历史跨越
深度学习革命的核心工程钥匙之一,在于模型计算范式从中央处理器(CPU)向图形处理器(GPU)的战略性迁移。GPU 芯片最初专为3D计算机游戏与图形渲染设计,但研究人员敏锐地发现,其高度并行的架构能够同时执行数以千计的矩阵代数运算——而这恰恰与深度神经网络的矩阵乘法与张量计算需求完美契合。
2006年,英伟达(NVIDIA)推出了开创性的 CUDA(Compute Unified Device Architecture) 并行计算平台,掀起了一场计算工程领域的革命。CUDA 允许研究人员直接调用 GPU 的海量并行算力来处理高强度的科学计算与 AI 算法模型。这一工程突破为2012年 AlexNet 模型取得历史性胜利奠定了不可或缺的算力基石,正式宣告了深度学习时代的全面到来。
深度学习的理论架构与层级范式 (Architectural Principles of Deep Learning)
深度学习作为机器学习的高级演进分支,其核心依赖于深度神经网络(Deep Neural Networks, DNNs)。此类网络由包含输入层、输出层及数十至数百层隐层(Hidden Layers)的多层架构组成,每一层层级皆代表着对输入数据特征的进一步抽象与非线性表征提取。
以计算机视觉中的图像识别系统为例:
浅层网络(第一层): 仅提取边缘、轮廓与局部梯度等低阶几何特征;
中层网络: 组合低阶特征,表征更复杂的局部纹理与器官形状;
深层网络(高层): 实现高阶语义表征,最终完成对完整目标(如人类面部或特定车辆)的整体识别。
传统经典机器学习与深度学习之间的本质范式差异在于:
传统机器学习范式: 极其依赖领域专家进行人工特征工程(Feature Engineering),显式指定特征萃取规则,机器方能进行后续分类或回归;
深度学习范式: 实现了端到端(End-to-End)的表征学习,模型能够完全自主地直接从原始非结构化数据(Raw Data)中自动抽取最优的层级特征表征。
正是这一卓越的表征学习能力,使得深度学习在计算机视觉、语音识别、自然语言处理等极高维度的复杂认知任务中取得了前所未有的工程突破。
神经网络的复兴 (Resurgence of Neural Networks)
在1980年代,杰弗里·辛顿(Geoffrey Hinton)、戴维·鲁梅哈特(David Rumelhart)及罗纳德·威廉姆斯(Ronald Williams)等学者深入系统地完善并推广了反向传播算法(Backpropagation)。该算法为多层神经网络的参数优化与梯度计算提供了严谨且高效的数学方法。然而在当时,受限于计算硬件的处理速度与可用数据集的规模,超大规模神经网络的训练在工程层面仍无法实现。
进入2000年代,随着 GPU 算力芯片加速性能的飞跃以及互联网全网级海量数据集的积累,研究人员重新聚焦于这一路线,成功实现了深层神经网络的高效训练与参数收敛。这一突破直接构成了深度学习(Deep Learning)革命的理论与工程基石。
ImageNet 项目与2012年“大爆发” (The ImageNet Landmark: 2012)
科技史与人工智能学术界普遍将2012年确立为深度学习革命的正式爆发元年。是年,亚历克斯·克里哲夫斯基(Alex Krizhevsky)、伊利亚·苏茨克维(Ilya Sutskever)及杰弗里·辛顿(Geoffrey Hinton)联合设计了名为 AlexNet 的深度卷积神经网络,参加了年度 ImageNet 大规模视觉识别挑战赛(ILSVRC)。
AlexNet 依托卷积神经网络(Convolutional Neural Network, CNN)架构,并在 GPU 高效并行算力的驱动下,将图像分类的错误率实现了阶跃式的骤降,以绝对优势击败了所有基于传统手工特征工程的竞演模型。这一标志性胜利实证了深度学习在处理高维复杂现实问题上的压倒性优势,直接促使全球顶尖学术机构、科技巨头及国际资本向该领域倾注了极其庞大的研发资源。
深度学习模型架构的演进 (Evolution of Deep Learning Architectures)
在 AlexNet 取得突破之后,各种专门化的神经网络架构相继演进成熟,分别推动了不同应用领域的范式重塑:
卷积神经网络(CNNs): 专用于计算机视觉、目标检测、视频分析及医学影像诊断;
循环神经网络(RNNs): 专用于处理文本、时序及语音等高维序列数据;
长短期记忆网络(LSTM): 解决了传统 RNN 在长序列关联中的梯度消失问题,显著提升了上下文语义表征能力;
Transformer 架构: 于2017年由 Google Brain 团队提出,引入了自注意力机制(Self-Attention Mechanism),构成了当今大语言模型(LLMs)及生成式人工智能(Generative AI)的核心理论基石。
深度学习的工程应用与社会影响 (Practical Impact of Deep Learning)
深度学习在多个关键工程与社会领域催生了根本性的变革:
计算机视觉: 智能终端人脸识别、医学 X 光/MRI 辅助诊断及自动驾驶感知与规控系统;
自然语言处理: 多语种高精度即时翻译、长文本自动摘要及智能对话系统(如 ChatGPT);
语音识别与合成: 语音助手、即时语音转文字引擎;
生物医药与大健康: 基因组学(DNA)关联分析、蛋白质结构预测及新药分子靶点筛选;
工业与商业智能: 市场需求预测、自动化质量控制及个性化推荐系统。
深度学习的工程局限与理论挑战 (Limitations and Challenges)
尽管取得了极其瞩目的成就,深度学习路线依然面临着严峻的理论与工程瓶颈:
极高的算力门槛与数据依赖: 模型的参数训练极其依赖规模庞大的海量数据集与昂贵的高能耗算力集群,导致研发与部署成本居高不下;
“黑盒”可解释性困境(Black Box Problem): 深层神经网络具备高度复杂的非线性表征机制,使得决策过程与推导逻辑极难进行可解释性分析。这种隐蔽性在医疗诊断、司法判决及高风险金融决策等关键领域引发了严峻的信任与监管关切。
生成式人工智能(Generative AI)与 ChatGPT:内容生产的新纪元
在2010年代末至2020年代初,人工智能跨入了一个崭新且具颠覆性的演化阶段——生成式人工智能(Generative AI)。与传统范式的本质差异在于:生成式 AI 不再局限于对既有数据的分析、判别或分类,而是具备了自主创作文本、图像、音频、视频及代码等全新的非结构化内容的能力。这一跃迁将 AI 从单一的数据分析工具,重塑为具备创造性协同能力的智能伙伴。
生成式 AI 的概念界定 (Concept of Generative AI)
生成式 AI 是人工智能的前沿演进分支。其核心机制在于通过对超大规模非结构化数据集的深度学习,精准拟合数据背后的潜在分布、概率流形与隐性关联;随后在输入提示(Prompt)驱动下,生成遵循该分布的全新原创内容,而非对已有数据的机械重复。
算力基础设施与大语言模型(LLMs)的飞跃
大语言模型(Large Language Models, LLMs)与生成式 AI 的蓬勃演进,高度依赖于算力硬件工程的跨越式突破。训练具备数百亿至万亿级参数的大模型,需要数以万计的 GPU 芯片在超大规模集群中执行高效并行计算。
目前,英伟达(NVIDIA)旗下的高性能加速芯片(如 A100 与 H100)构成了全球 AI 基础设施的关键技术支柱。依托其 CUDA 并行计算架构,研究人员得以最大化释放硬件性能,进而驱动全球范围内前沿生成式 AI 服务的迭代与演进。
大语言模型(LLMs)的技术范式与能力表征
基于 Transformer 架构的优异表征能力,大语言模型在数百亿至数万亿词代(Tokens)的高维语料库上进行预训练,使其能够深刻理解自然语言中极为复杂的语义关联与逻辑上下文。
大语言模型展现出了卓越的多任务泛化能力:
严谨的逻辑推导与问题求解;
高质量文本撰写与长篇语料摘要;
多语种间的流利机器翻译;
软件工程代码的自动生成、重构与 Bug 诊断;
语法规范与语义逻辑的精细纠错;
辅助科研人员进行文献萃取与复杂归纳。
这些能力使得生成式 AI 成为了科技史上演进速度最快、影响最为深刻的工程突破之一。
ChatGPT 模型:人机对话交互的历史性突破
ChatGPT 是生成式 AI 领域最具代表性与知名度的工程落地成果。该系统由 OpenAI 开发,构建于 GPT(Generative Pre-trained Transformer) 架构演进路线之上。
当 ChatGPT 于2022年11月30日正式向公众发布时,在短短数天内即吸引了全球数以百万计的用户。这一现象级的工程成功实证了:人类社会已准备好将人工智能作为学习、撰写、编程及跨语言交流的日常智能工具。
核心技术工程: ChatGPT 的卓越性能不仅源于大规模预训练,还深度融合了**基于人类反馈的强化学习(Reinforcement Learning from Human Feedback, RLHF)**技术。这使得模型能够精准对齐人类意图,生成符合自然语言对话习惯、逻辑严密且高度贴切的响应。
ChatGPT 的工程成功要素: 除去在超大规模语料库上的基础预训练之外,该模型的核心突破在于深度融合了**基于人类反馈的强化学习(Reinforcement Learning from Human Feedback, RLHF)**技术。这一机制使得模型能够高度对齐人类意图,生成结构严谨、逻辑贴切且高度符合人类自然语言对话习惯的响应。
生成式人工智能的多维工程应用 (Multidisciplinary Applications of Generative AI)
生成式人工智能目前已在多个核心产业领域引发了颠覆性的范式重塑:
教育与学术演进: 自动化课程摘要生成、高难度科学概念的解构阐释,以及作为个性化导师赋能定制化教学;
医疗与智慧大健康: 辅助临床医生快速撰写病历报告,以及高维患者数据的智能化分析;
软件工程与代码生成: 赋能软件开发人员进行自动化代码撰写、程序 Bug 诊断(Debugging)及代码逻辑解析;
数字媒体与新闻传播: 即时新闻稿件拟定、深度专题撰写及多模态数字内容创作;
商业智能与市场营销: 创意广告文案生成、智能客户服务自动化及市场战略数据分析;
艺术创作与工业设计: 高质量原创图像生成、音乐合成、视频渲染及前沿视觉设计。
参考文献 (Academic Bibliography)
Russell, S., & Norvig, P. (2021). Artificial Intelligence: A Modern Approach (4th ed.). Pearson.
Turing, A. M. (1936). On Computable Numbers, with an Application to the Entscheidungsproblem. Proceedings of the London Mathematical Society, 2(42), 230–265.
Turing, A. M. (1950). Computing Machinery and Intelligence. Mind, 59(236), 433–460.
McCorduck, P. (2004). Machines Who Think: A Personal Inquiry into the History and Prospects of Artificial Intelligence (2nd ed.). A K Peters.
Nilsson, N. J. (2010). The Quest for Artificial Intelligence: A History of Ideas and Achievements. Cambridge University Press.
al-Jazarī, I. (1974). The Book of Knowledge of Ingenious Mechanical Devices (D. R. Hill, Trans.). D. Reidel Publishing Company.
Hill, D. R. (1998). Mechanical Engineering in the Medieval Near East. Scientific American, 264(5), 100–105.
Hill, D. R. (1991). Islamic Science and Engineering. Edinburgh University Press.
Encyclopaedia Britannica. al-Jazari.
Ceccarelli, M. (2004). Distinguished Figures in Mechanism and Machine Science. Springer.